راهنمای جامع مانیتورینگ فارم ماینینگ؛ چه اطلاعاتی باید همیشه کنترل شوند؟
در یک فارم کوچک با چند دستگاه، بررسی دستی وضعیت ماینرها ممکن است هنوز امکانپذیر باشد. اما با افزایش تعداد تجهیزات، مدیریت فارم بهسرعت پیچیده میشود.
اگر صدها دستگاه در یک مجموعه فعالیت کنند، تنها روشن بودن چراغ ماینر یا باز شدن صفحه مدیریت آن نشان نمیدهد که دستگاه واقعاً با ظرفیت مناسب در حال استخراج است.
ممکن است دستگاه آنلاین باشد اما:
- بخشی از هشریت خود را از دست داده باشد؛
- یک هشبرد از مدار خارج شده باشد؛
- دمای آن بیش از حد افزایش پیدا کرده باشد؛
- تعداد Reject آن بالا رفته باشد؛
- یکی از فنها بهدرستی کار نکند؛
- ارتباط دستگاه با استخر ناپایدار باشد؛
- یا دستگاه مرتباً ریست شود.
به همین دلیل، مانیتورینگ فارم باید تصویری کامل از سلامت تجهیزات، عملکرد استخراج، شبکه، انرژی و زیرساخت در اختیار مدیر مجموعه قرار دهد.
در این مقاله مهمترین اطلاعاتی را بررسی میکنیم که در یک فارم استخراج حرفهای باید بهصورت مستمر کنترل شوند.
مانیتورینگ فارم دقیقاً چیست؟
مانیتورینگ فارم یعنی جمعآوری، ثبت و تحلیل مستمر اطلاعات تجهیزات و زیرساخت با هدف تشخیص سریع شرایط غیرعادی.
هدف فقط این نیست که بدانیم ماینر روشن است یا خاموش.
یک سیستم مانیتورینگ مناسب باید بتواند به پرسشهایی مانند این پاسخ دهد:
آیا دستگاه با توان مورد انتظار کار میکند؟
آیا عملکرد آن نسبت به دیروز کاهش پیدا کرده است؟
آیا دما در محدوده مناسب قرار دارد؟
آیا دستگاه به استخر متصل است؟
آیا تعداد خطاها افزایش یافته است؟
از چه زمانی مشکل ایجاد شده است؟
چند دستگاه همزمان تحت تأثیر یک مشکل قرار گرفتهاند؟
در واقع مانیتورینگ باید به مدیر فارم کمک کند مشکل را قبل از آنکه به توقف طولانی یا کاهش جدی هشریت تبدیل شود شناسایی کند.
1. هشریت؛ مهمترین شاخص عملکرد ماینر
هشریت اولین عددی است که اکثر مدیران فارم بررسی میکنند.
اما تنها مشاهده یک مقدار لحظهای کافی نیست.
برای هر ماینر بهتر است حداقل چند نوع هشریت قابل بررسی باشد:
- هشریت لحظهای
- میانگین کوتاهمدت
- میانگین یکساعته
- میانگین ۲۴ ساعته
دلیل این موضوع ساده است.
هشریت لحظهای ممکن است بهطور طبیعی نوسان داشته باشد. اگر تنها همان مقدار بررسی شود، ممکن است یک تغییر طبیعی با خرابی اشتباه گرفته شود.
در مقابل، کاهش مداوم میانگین هشریت میتواند نشانه وجود یک مشکل واقعی باشد.
مثال
فرض کنیم یک دستگاه با هشریت اسمی 200 TH/s فعالیت میکند.
اگر لحظهای عدد 185 TH/s نمایش داده شود، الزاماً مشکل خاصی وجود ندارد.
اما اگر میانگین چندساعته آن از 200 به 160 TH/s کاهش پیدا کند، باید علت بررسی شود.
ممکن است:
- یک هشبرد از مدار خارج شده باشد؛
- دستگاه به دلیل دما فرکانس خود را کاهش داده باشد؛
- پاور مشکل داشته باشد؛
- یا بخشی از چیپها بهدرستی فعالیت نکنند.
به همین دلیل روند هشریت از خود عدد هشریت مهمتر است.
2. تفاوت هشریت دستگاه و هشریت استخر
یکی از مهمترین مواردی که باید در مانیتورینگ بررسی شود، تفاوت میان:
Local Hashrate
و
Pool-side Hashrate
است.
Local Hashrate عددی است که خود ماینر بر اساس فعالیت چیپهایش محاسبه میکند.
اما هشریت سمت استخر بر اساس Shareهایی که واقعاً از دستگاه دریافت شدهاند تخمین زده میشود.
به همین دلیل ممکن است یک ماینر در صفحه داخلی خود هشریت مناسبی نشان دهد اما در سمت استخر عملکرد پایینتری داشته باشد.
این اختلاف میتواند دلایل مختلفی داشته باشد:
- قطعی اینترنت
- Packet Loss
- ناپایداری ارتباط
- Reject بالا
- تغییر مکرر Pool
- مشکل DNS
- تأخیر زیاد شبکه
- ریست شدن دستگاه
برای ارزیابی واقعی عملکرد فارم، بهتر است هر دو سمت بررسی شوند.
3. وضعیت آنلاین و آفلاین تجهیزات
Online بودن سادهترین شاخص مانیتورینگ است، اما حتی همین وضعیت نیز باید با دقت تعریف شود.
اینکه یک ماینر به شبکه داخلی پاسخ میدهد الزاماً به این معنی نیست که در حال استخراج است.
بهتر است چند وضعیت مجزا وجود داشته باشد:
Online و در حال استخراج
دستگاه در دسترس است و هشریت مناسب تولید میکند.
Online اما بدون هشریت
دستگاه از طریق شبکه قابل دسترس است، اما استخراج متوقف شده است.
هشریت پایین
دستگاه فعال است اما عملکرد آن پایینتر از محدوده تعیینشده است.
Offline
هیچ ارتباطی با دستگاه وجود ندارد.
این تفکیک باعث میشود عیبیابی بسیار سریعتر انجام شود.
4. مدت زمان توقف یا Downtime
یکی از شاخصهایی که معمولاً کمتر مورد توجه قرار میگیرد، مدت زمان توقف دستگاه است.
فرض کنیم یک ماینر روزانه فقط 20 دقیقه خاموش باشد.
ممکن است این عدد کوچک به نظر برسد.
اما اگر فارم 1000 دستگاه داشته باشد و تعداد زیادی از تجهیزات چنین توقفهایی داشته باشند، مجموع ظرفیت ازدسترفته قابل توجه خواهد بود.
به همین دلیل بهتر است سیستم مانیتورینگ ثبت کند:
- دستگاه چه زمانی آفلاین شده؛
- چه مدت آفلاین بوده؛
- چند بار در روز قطع شده؛
- و آیا این رفتار در روزهای گذشته نیز تکرار شده است.
گاهی تعداد قطعیها از مدت یک قطعی مهمتر است.
ماینری که روزانه ده بار ریست میشود احتمالاً مشکلی دارد، حتی اگر هر بار خیلی سریع دوباره آنلاین شود.
5. دمای ماینر
دما یکی از مهمترین شاخصهای سلامت تجهیزات استخراج است.
ماینرها در زمان فعالیت مقدار زیادی گرما تولید میکنند و عملکرد آنها به شرایط حرارتی مناسب وابسته است.
دمای بالا میتواند باعث موارد زیر شود:
- کاهش هشریت
- افزایش خطای چیپها
- افزایش سرعت فن
- استهلاک بیشتر تجهیزات
- ریست دستگاه
- یا خاموشی حفاظتی
در مانیتورینگ بهتر است دما فقط بهعنوان یک عدد دیده نشود.
روند تغییر دما اهمیت بیشتری دارد.
برای مثال اگر یک دستگاه همیشه در محدوده مشخصی فعالیت کرده اما دمای آن بهتدریج در حال افزایش باشد، ممکن است مشکلی مانند:
- گرفتگی مسیر هوا
- کثیفی دستگاه
- خرابی فن
- افزایش دمای محیط
- یا مشکل سیستم تهویه
وجود داشته باشد.
6. وضعیت فنها
در ماینرهای Air Cooling، فن یکی از مهمترین قطعات عملیاتی دستگاه است.
کاهش دور فن یا توقف کامل آن میتواند خیلی سریع باعث افزایش دما شود.
سیستم مانیتورینگ بهتر است موارد زیر را ثبت کند:
- RPM هر فن
- توقف فن
- اختلاف غیرعادی سرعت میان فنها
- تغییر ناگهانی RPM
- خطای Fan Lost
بررسی روند سرعت فن نیز میتواند اطلاعات مفیدی درباره شرایط تهویه ارائه دهد.
اگر تمام فنهای یک بخش از فارم بهطور همزمان با دور بالاتر فعالیت کنند، ممکن است مشکل از خود دستگاهها نباشد و دمای محیط افزایش یافته باشد.
7. وضعیت هشبردها
بسیاری از ASICها دارای چند Hashboard هستند.
ممکن است دستگاه از نظر شبکه کاملاً آنلاین باشد اما یکی از هشبردها از مدار خارج شده باشد.
در این حالت دستگاه همچنان استخراج میکند، ولی بخشی از هشریت آن از دست رفته است.
به همین دلیل بهتر است موارد زیر قابل مشاهده باشند:
- تعداد هشبردهای فعال
- هشریت هر برد
- تعداد چیپهای فعال
- وضعیت بردها
- خطاهای مرتبط با Hashboard
این نوع مشکل یکی از دلایلی است که نشان میدهد صرفاً بررسی Online/Offline بودن دستگاه کافی نیست.
8. خطاهای ASIC و Hardware Error
خطاهای سختافزاری باید در طول زمان بررسی شوند.
وجود تعداد محدودی خطا الزاماً به معنای خرابی دستگاه نیست، اما افزایش غیرعادی آن میتواند نشانه مشکلی باشد.
مواردی مانند:
- Hardware Error
- ASIC Error
- CRC Error
- Chain Error
- Missing Chip
میتوانند در برخی مدلها اطلاعات ارزشمندی درباره سلامت دستگاه ارائه دهند.
نکته مهم این است که تغییر روند خطاها بررسی شود.
اگر دستگاهی که همیشه عملکرد پایدار داشته ناگهان شروع به تولید تعداد زیادی خطا کند، باید مورد بررسی قرار گیرد.
9. Accepted و Rejected Share
در استخراج استخرمحور، ماینر مرتباً Share ارسال میکند.
Shareهای معتبر توسط استخر Accepted میشوند.
اما بخشی از Shareها ممکن است Reject شوند.
Reject بالا میتواند به دلایل مختلفی ایجاد شود:
- ارتباط ناپایدار
- Packet Loss
- Latency
- تنظیمات نادرست
- Stale Share
- مشکلات نرمافزاری
- یا خطای سختافزاری
در یک سیستم مانیتورینگ حرفهای بهتر است فقط تعداد Reject نمایش داده نشود.
درصد Reject نسبت به Accepted معیار بسیار مفیدتری است.
همچنین روند تغییر Reject در طول زمان اهمیت زیادی دارد.
اگر Reject تعداد زیادی از ماینرها بهطور همزمان افزایش پیدا کند، احتمالاً باید شبکه یا ارتباط با استخر بررسی شود.
اگر فقط یک دستگاه مشکل دارد، منشأ ایراد ممکن است خود ماینر باشد.
10. وضعیت اتصال به Pool
یکی دیگر از اطلاعات مهم، Poolی است که دستگاه در حال حاضر به آن متصل شده است.
بسیاری از ماینرها امکان تعریف چند Stratum دارند:
- Pool 1
- Pool 2
- Pool 3
اگر Pool اصلی از دسترس خارج شود، ماینر ممکن است به آدرس Backup منتقل شود.
این رفتار باید مانیتور شود.
برای مثال اگر گروهی از دستگاهها بدون دلیل به Pool دوم منتقل شده باشند، ممکن است مشکلی در ارتباط با Pool اصلی یا شبکه وجود داشته باشد.
سیستم مانیتورینگ بهتر است مشخص کند:
- Pool فعال فعلی
- زمان آخرین تغییر Pool
- تعداد Disconnectها
- وضعیت اتصال
- مدت اتصال فعلی
11. وضعیت شبکه
فارم استخراج حجم بسیار زیادی از اینترنت مصرف نمیکند، اما به اتصال پایدار نیاز دارد.
مواردی مانند:
- Packet Loss
- Latency بالا
- قطع و وصل شدن لینک
- مشکل DNS
- تداخل IP
- خرابی Switch
- مشکل DHCP
میتوانند روی عملکرد تجهیزات اثر بگذارند.
برای همین بهتر است مانیتورینگ تنها روی خود ASICها تمرکز نکند.
تجهیزات شبکه نیز بخشی از زیرساخت فارم هستند.
در فارمهای بزرگ، Switchها، Routerها، لینکهای اینترنت و تجهیزات ارتباطی بهتر است در همان ساختار مانیتورینگ زیرساخت قرار بگیرند.
12. مصرف برق
هشریت بدون توجه به مصرف انرژی تصویر کاملی از عملکرد دستگاه ارائه نمیدهد.
برای مثال ممکن است دو دستگاه هر دو 200 TH/s تولید کنند اما یکی برق بسیار بیشتری مصرف کند.
در صورت دسترسی به اطلاعات مصرف، بهتر است شاخصهای زیر ثبت شوند:
- توان لحظهای
- انرژی مصرفی
- جریان
- ولتاژ
- مصرف هر دستگاه
- مصرف هر رک یا سالن
- مصرف کل فارم
این دادهها امکان محاسبه راندمان واقعی را نیز فراهم میکنند.
13. راندمان انرژی یا J/TH
یکی از مهمترین شاخصهای نسل جدید تجهیزات استخراج، J/TH است.
این شاخص مشخص میکند برای تولید هر تراهش توان پردازشی چه مقدار انرژی مصرف میشود.
هرچه J/TH کمتر باشد، دستگاه از نظر انرژی کارآمدتر است.
اما راندمان واقعی یک دستگاه میتواند با مقدار اسمی اعلامشده توسط سازنده متفاوت باشد.
برای مثال:
اگر ماینر برق مصرف کند ولی به دلیل گرما یا مشکل سختافزاری هشریت آن کاهش پیدا کند، J/TH واقعی بدتر میشود.
بنابراین ترکیب دادههای مصرف برق و هشریت میتواند یکی از دقیقترین معیارهای ارزیابی عملکرد باشد.
14. پاور ماینر
Power Supply یکی از قطعات مهم و در عین حال پرتنش تجهیزات استخراج است.
مشکلات پاور ممکن است باعث:
- ریست شدن ماینر
- کاهش هشریت
- از مدار خارج شدن هشبرد
- ناپایداری دستگاه
- یا خاموشی کامل
شود.
اگر دستگاه اطلاعات ولتاژ، توان یا خطای پاور را ارائه کند، بهتر است این دادهها نیز جمعآوری شوند.
تکرار ریست دستگاه در فاصلههای نامنظم یکی از نشانههایی است که میتواند اپراتور را به بررسی پاور هدایت کند.
15. Uptime
Uptime نشان میدهد دستگاه چه مدت بدون توقف فعالیت کرده است.
این شاخص ساده میتواند اطلاعات زیادی در اختیار مدیر فارم قرار دهد.
برای مثال اگر اکثر دستگاههای یک سالن Uptime چندروزه دارند اما یک دستگاه فقط 40 دقیقه Uptime دارد، مشخص است که آن دستگاه اخیراً ریست شده است.
با مقایسه Uptime تجهیزات میتوان دستگاههایی را که مرتباً ریست میشوند سریعتر پیدا کرد.
16. تعداد Restartها
صرفاً نمایش Uptime کافی نیست.
بهتر است تعداد دفعات Restart نیز ثبت شود.
یک ماینر ممکن است:
- امروز سه بار
- هفته گذشته 15 بار
- و ماه گذشته 70 بار
ریست شده باشد.
این رفتار میتواند نشانه یک مشکل مزمن باشد.
بدون ثبت تاریخچه، ممکن است اپراتور هر بار دستگاه را آنلاین ببیند و تصور کند مشکلی وجود ندارد.
17. تاریخچه تغییرات
اطلاعات لحظهای فقط بخشی از مانیتورینگ هستند.
برای عیبیابی جدی، باید تاریخچه وجود داشته باشد.
بهتر است بتوان دادههای دستگاه را در بازههای مختلف بررسی کرد:
- چند ساعت گذشته
- 24 ساعت
- 7 روز
- 30 روز
وجود نمودارها کمک میکند تغییرات تدریجی شناسایی شوند.
برای مثال کاهش آرام هشریت در طول چند روز ممکن است در بررسی لحظهای دیده نشود.
18. هشدارها
سیستم مانیتورینگ نباید انتظار داشته باشد مدیر فارم دائماً صفحه داشبورد را نگاه کند.
به همین دلیل Alerting یکی از مهمترین بخشهای مانیتورینگ است.
نمونه هشدارهای مفید:
- ماینر Offline شد
- هشریت کمتر از حد تعیینشده است
- دما بیش از حد مجاز است
- یک هشبرد از مدار خارج شده
- Fan Error ثبت شده
- Reject افزایش یافته
- دستگاه مرتباً Restart میشود
- ارتباط با Pool تغییر کرده است
اما هشدار زیاد نیز مشکل ایجاد میکند.
اگر اپراتور در هر دقیقه دهها پیام غیرضروری دریافت کند، بهمرور هشدارهای مهم را نیز نادیده میگیرد.
بنابراین Thresholdها باید منطقی تنظیم شوند.
19. وضعیت کلی فارم
مدیر فارم همیشه نیاز ندارد وارد جزئیات هزار دستگاه شود.
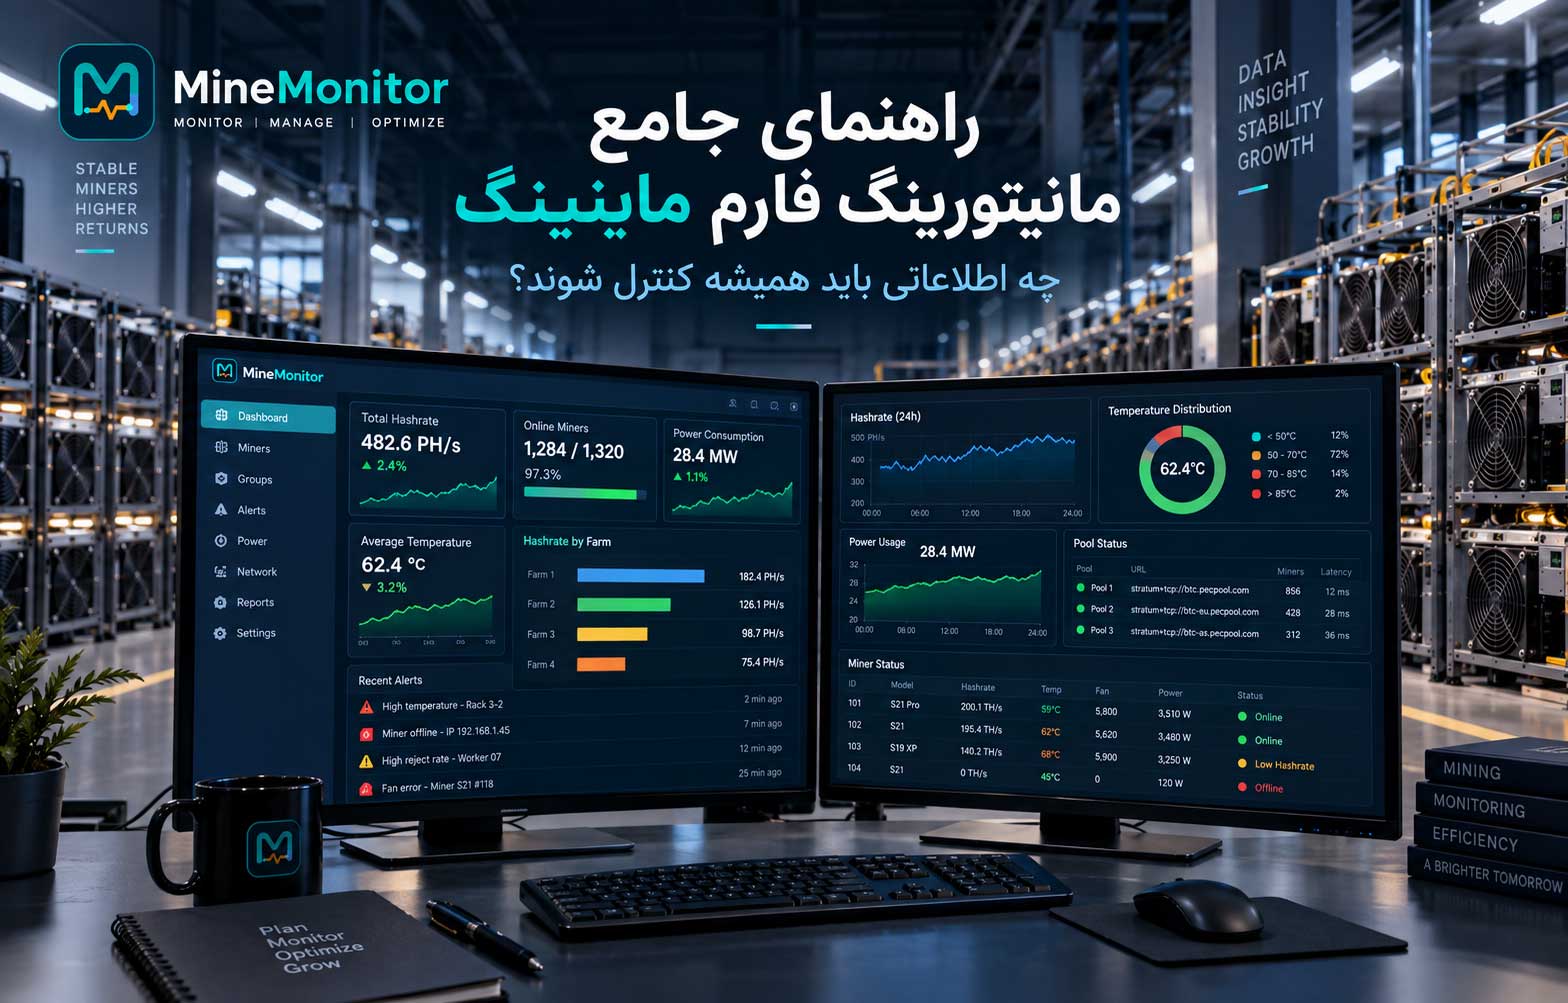
داشبورد اصلی باید در چند ثانیه وضعیت کلی مجموعه را نشان دهد.
برای مثال:
کل هشریت:
توان پردازشی واقعی مجموعه
تعداد کل ماینرها
ماینرهای Online
ماینرهای Offline
ماینرهای دارای هشریت پایین
تعداد دستگاههای دارای هشدار
میانگین دما
Reject کل فارم
مصرف انرژی
هدف این است که مدیر با مشاهده یک صفحه متوجه شود آیا وضعیت کلی عادی است یا خیر.
20. گروهبندی تجهیزات
در فارمهای بزرگ، همه دستگاهها نباید در یک فهرست ساده نمایش داده شوند.
بهتر است تجهیزات بر اساس ساختار واقعی مجموعه گروهبندی شوند.
برای مثال:
Site → Hall → Row → Rack → Miner
یا:
مزرعه → سالن → خط برق → دستگاه
این ساختار باعث میشود وقتی مشکلی در یک بخش ایجاد میشود سریع مشخص شود آیا تجهیزات مشکلدار در یک موقعیت مشترک قرار دارند یا خیر.
اگر تمام دستگاههای یک Rack همزمان Offline شوند، احتمال خرابی تکتک ماینرها بسیار کم است.
در چنین شرایطی باید مواردی مانند:
- Switch
- PDU
- فیوز
- برق ورودی
- یا شبکه همان Rack
بررسی شوند.
چرا مانیتورینگ متمرکز اهمیت دارد؟
در یک فارم بزرگ، اطلاعات از منابع مختلف میآیند.
خود ماینر یک سری اطلاعات دارد.
استخر دادههای دیگری دارد.
شبکه وضعیت متفاوتی ارائه میکند.
سیستم برق نیز اطلاعات مخصوص خود را دارد.
اگر تمام این دادهها جداگانه بررسی شوند، تشخیص ارتباط میان مشکلات دشوار میشود.
مانیتورینگ متمرکز کمک میکند تصویر کاملتری ساخته شود.
برای مثال:
هشریت کاهش یافته + دما افزایش یافته
احتمالاً مشکل حرارتی وجود دارد.
هشریت Pool کاهش یافته + Local Hashrate طبیعی است
شبکه یا ارتباط با استخر باید بررسی شود.
چندین دستگاه در یک Rack آفلاین شدهاند
زیرساخت مشترک باید بررسی شود.
مصرف برق طبیعی است اما هشریت کاهش یافته
ممکن است بخشی از تجهیزات با راندمان پایین فعالیت کنند.
این ارتباط میان دادههاست که مانیتورینگ را از یک صفحه نمایش ساده به ابزار مدیریت تبدیل میکند.
مانیتورینگ خوب باید چه ویژگیهایی داشته باشد؟
یک سامانه حرفهای بهتر است چند ویژگی اصلی داشته باشد.
اطلاعات Real-Time
وضعیت فعلی تجهیزات باید با تأخیر حداقلی قابل مشاهده باشد.
تاریخچه
بدون تاریخچه نمیتوان روند مشکلات را بررسی کرد.
هشدار قابل تنظیم
مدیر باید بتواند Thresholdها را براساس شرایط فارم تعیین کند.
دستهبندی تجهیزات
مدیریت هزار دستگاه بدون ساختار مناسب دشوار است.
نمودارهای قابل فهم
نمودار باید به تصمیمگیری کمک کند، نه اینکه فقط صفحه را شلوغ کند.
امکان مقایسه
مقایسه دستگاهها و گروههای مختلف میتواند تجهیزات غیرعادی را مشخص کند.
ثبت رخدادها
مشخص باشد دستگاه چه زمانی Offline شده، چه زمانی برگشته و چه هشدارهایی داشته است.
چه چیزهایی باید روی داشبورد اصلی باشند؟
اگر بخواهیم اطلاعات داشبورد اصلی را محدود کنیم، این موارد بیشترین اهمیت را دارند:
| شاخص | دلیل اهمیت |
|---|---|
| Total Hashrate | مشاهده خروجی واقعی فارم |
| Online Miners | سلامت کلی تجهیزات |
| Offline Miners | تشخیص توقفها |
| Low Hashrate | پیدا کردن تجهیزات کمبازده |
| Reject Rate | تشخیص مشکلات شبکه یا استخراج |
| Temperature | کنترل شرایط حرارتی |
| Alerts | تمرکز روی مشکلات فوری |
| Uptime | تشخیص ریستها و ناپایداری |
| Power | ارزیابی مصرف انرژی |
| Efficiency | مقایسه انرژی و هشریت |
جزئیات بیشتر باید در صفحات تخصصی دستگاه، سالن یا سایت قابل مشاهده باشند.
مانیتورینگ جای نگهداری را نمیگیرد
یک نکته مهم این است که مانیتورینگ بهتنهایی مشکل را حل نمیکند.
سیستم مانیتورینگ وظیفه دارد:
مشکل را شناسایی کند، محل آن را مشخص کند و اطلاعات لازم برای تصمیمگیری را ارائه دهد.
اما همچنان به فرآیند نگهداری نیاز است.
برای مثال اگر سیستم افزایش دمای یک دستگاه را گزارش کند، اپراتور باید علت را بررسی کند.
ممکن است:
- فیلتر کثیف باشد؛
- فن آسیب دیده باشد؛
- جریان هوا مناسب نباشد؛
- یا محیط بیش از حد گرم شده باشد.
بهترین نتیجه زمانی به دست میآید که مانیتورینگ و نگهداری در کنار یکدیگر قرار گیرند.
از مانیتورینگ دستگاه تا مدیریت کل فارم
صنعت استخراج در حال حرکت از مدیریت تکدستگاه به سمت مدیریت زیرساخت است.
در یک فارم مدرن دیگر فقط ASIC اهمیت ندارد.
برق، شبکه، خنکسازی، امنیت، ارتباطات و سیستم کنترل همگی بخشی از یک مجموعه هستند.
در نتیجه نسل جدید سامانههای مانیتورینگ نیز باید بتوانند تصویر جامعتری از عملیات ارائه دهند.
مدیر فارم باید بتواند از یک دید کلی شروع کند و در صورت مشاهده مشکل، مرحلهبهمرحله تا دستگاه یا بخش دقیق دارای ایراد پیش برود.
این رویکرد باعث میشود:
- زمان شناسایی خرابی کاهش پیدا کند؛
- Downtime تجهیزات کمتر شود؛
- ظرفیت واقعی فارم بهتر حفظ شود؛
- مشکلات تکرارشونده شناسایی شوند؛
- و تصمیمات نگهداری بر اساس داده واقعی انجام شوند.
جمعبندی
مانیتورینگ حرفهای فارم بسیار فراتر از مشاهده تعداد دستگاههای آنلاین است.
برای ارزیابی دقیق عملکرد باید مجموعهای از شاخصها در کنار یکدیگر بررسی شوند:
هشریت، وضعیت دستگاه، دما، فن، هشبرد، خطاها، Accepted و Reject، اتصال به استخر، شبکه، مصرف برق، راندمان و تاریخچه عملکرد.
ارزش اصلی مانیتورینگ زمانی مشخص میشود که این دادهها بتوانند به یک سؤال ساده پاسخ دهند:
آیا فارم در همین لحظه با حداکثر ظرفیت سالم و قابل انتظار خود فعالیت میکند؟
اگر پاسخ منفی باشد، سیستم باید بتواند مدیر مجموعه را به سمت علت احتمالی مشکل هدایت کند.
در فارمهای بزرگ، هرچه تعداد تجهیزات بیشتر شود، این موضوع اهمیت بیشتری پیدا میکند؛ زیرا مشکلات کوچک در مقیاس صدها یا هزاران دستگاه میتوانند به مقدار قابل توجهی از هشریت و زمان عملیاتی ازدسترفته تبدیل شوند.
به همین دلیل، مانیتورینگ را باید یکی از اجزای اصلی زیرساخت یک فارم حرفهای دانست، نه یک ابزار جانبی.