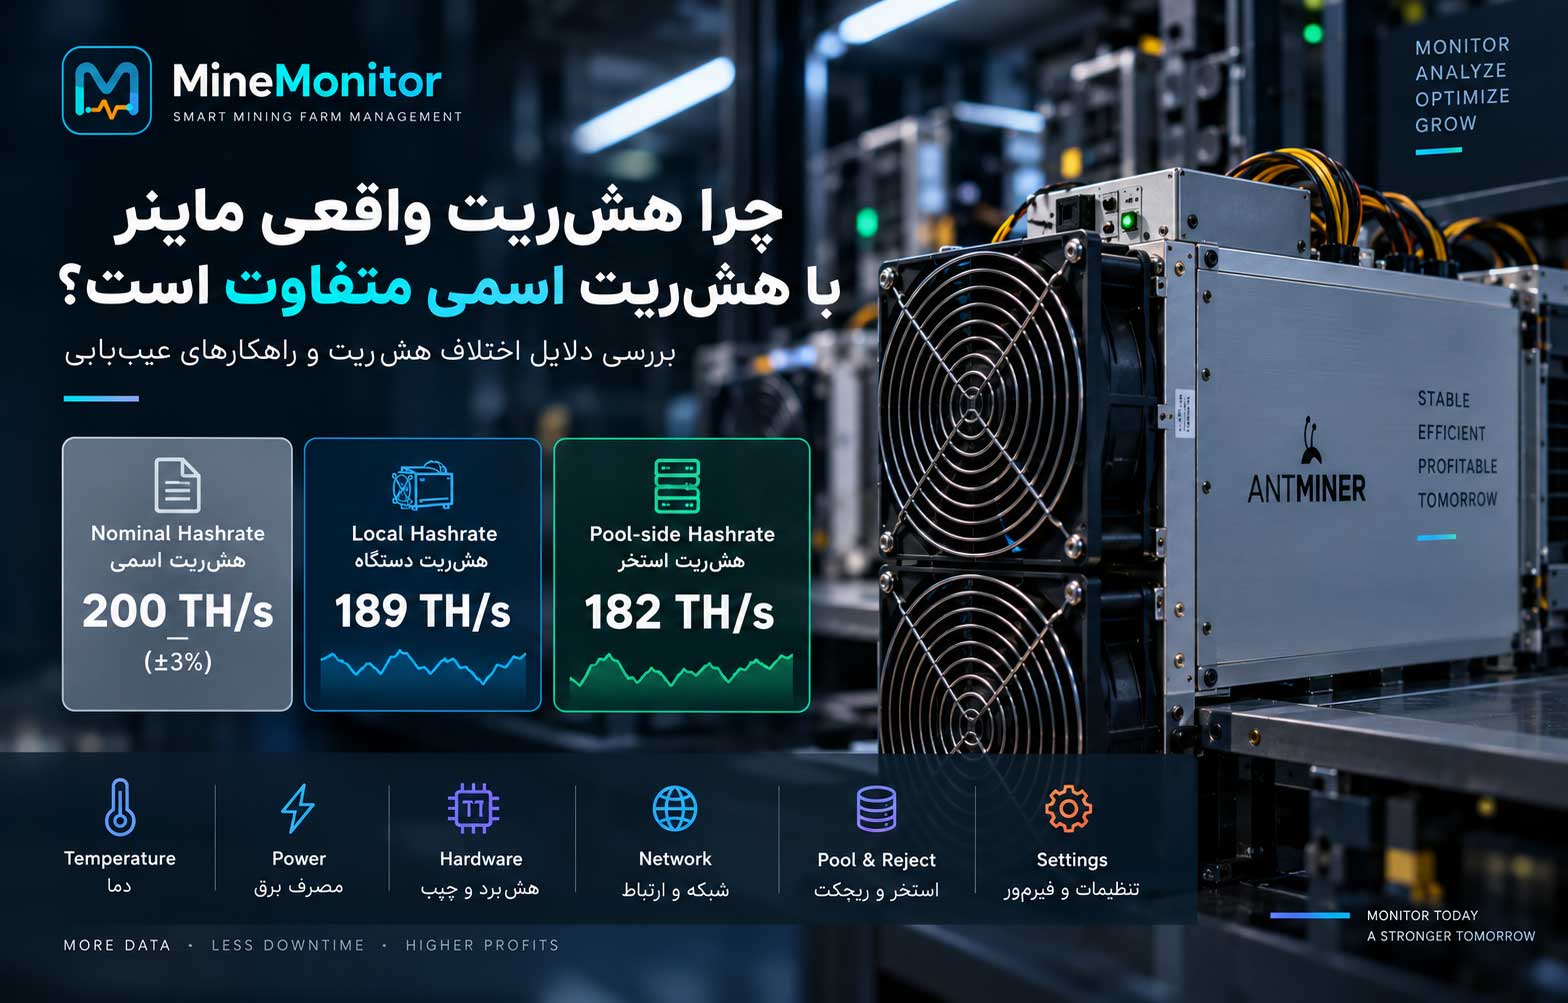
چرا هشریت واقعی ماینر با هشریت اسمی متفاوت است؟
یکی از رایجترین پرسشهای مدیران فارم این است:
چرا ماینری که مثلاً 200 TH/s معرفی شده، در عمل 190، 180 یا حتی گاهی 210 TH/s نشان میدهد؟
در نگاه اول ممکن است تصور شود هر عددی کمتر از مقدار درجشده در مشخصات دستگاه نشانه خرابی است، اما موضوع به این سادگی نیست.
در استخراج بیتکوین چند نوع هشریت مختلف وجود دارد و هرکدام به روش متفاوتی محاسبه میشوند.
عدد درجشده توسط سازنده، عدد نمایشدادهشده در پنل خود ماینر و هشریتی که استخر گزارش میکند الزاماً در هر لحظه یکسان نیستند.
برای تشخیص یک مشکل واقعی، ابتدا باید بدانیم کدام هشریت را با کدام عدد مقایسه میکنیم.
هشریت چیست؟
هشریت نشاندهنده تعداد محاسبات هش است که یک دستگاه یا مجموعه استخراج در هر ثانیه انجام میدهد.
در تجهیزات استخراج بیتکوین معمولاً از واحدهای زیر استفاده میشود:
- GH/s — گیگاهش بر ثانیه
- TH/s — تراهش بر ثانیه
- PH/s — پتاهش بر ثانیه
- EH/s — اگزاهش بر ثانیه
برای ASICهای امروزی، TH/s رایجترین واحد در سطح دستگاه است.
برای مثال:
200 TH/s
یعنی دستگاه از نظر نظری حدود 200 تریلیون عملیات هش در هر ثانیه انجام میدهد.
اما عددی که در عمل مشاهده میشود ممکن است تحت تأثیر عوامل مختلف تغییر کند.
سه نوع هشریت که نباید با هم اشتباه شوند
برای بررسی صحیح عملکرد ماینر بهتر است حداقل سه مفهوم را از هم جدا کنیم.
1. هشریت اسمی یا Nominal Hashrate
هشریت اسمی همان عددی است که سازنده برای دستگاه اعلام میکند.
برای مثال:
200 TH/s ± 3%
این عدد معمولاً در شرایط کاری مشخص و مطابق تنظیمات استاندارد دستگاه اندازهگیری شده است.
عبارت ±3% نیز اهمیت زیادی دارد.
اگر دستگاهی با مشخصات 200 TH/s و تلرانس 3 درصد عرضه شده باشد، محدودهای در حدود:
194 تا 206 TH/s
میتواند همچنان در محدوده مشخصات سازنده قرار داشته باشد.
بنابراین انتظار اینکه تمام دستگاههای یک مدل دقیقاً روی یک عدد ثابت کار کنند منطقی نیست.
2. هشریت محلی یا Local Hashrate
Local Hashrate عددی است که خود ماینر محاسبه و در پنل مدیریتی نمایش میدهد.
این مقدار براساس فعالیت واقعی ASICها و هشبردهای دستگاه محاسبه میشود.
ممکن است پنل مواردی مانند این نمایش دهد:
- Real-time Hashrate
- Average Hashrate
- 5m Hashrate
- 15m Hashrate
- 1h Average
این اعداد حتی در خود دستگاه نیز میتوانند با یکدیگر تفاوت داشته باشند.
چرا؟
چون هرکدام مربوط به یک بازه زمانی متفاوت هستند.
یک مقدار لحظهای میتواند نوسان بیشتری داشته باشد، اما میانگین یکساعته معمولاً تصویر دقیقتری از عملکرد دستگاه ارائه میدهد.
3. هشریت سمت استخر یا Pool-side Hashrate
هشریت استخر به روش کاملاً متفاوتی محاسبه میشود.
استخر مستقیماً نمیداند ASIC داخل دستگاه در هر ثانیه چند هش محاسبه میکند.
بلکه عملکرد ماینر را براساس Shareهایی که از آن دریافت میکند تخمین میزند.
بهصورت ساده میتوان گفت:
Shareهای معتبر بیشتر در یک بازه زمانی = هشریت تخمینی بیشتر
به همین دلیل هشریت Pool-side ذاتاً یک مقدار تخمینی است.
چرا هشریت استخر نوسان بیشتری دارد؟
پیدا کردن Share یک فرآیند کاملاً یکنواخت نیست.
ممکن است یک ماینر در چند دقیقه Shareهای بیشتری پیدا کند و در چند دقیقه بعد تعداد کمتری ارسال کند.
بنابراین اگر استخر هشریت را فقط در یک بازه کوتاه محاسبه کند، ممکن است اعداد زیر مشاهده شوند:
یک لحظه:
225 TH/s
چند دقیقه بعد:
178 TH/s
و مدتی بعد:
203 TH/s
در حالی که خود دستگاه در تمام این مدت تقریباً با 200 TH/s کار کرده است.
این نوسان لزوماً به معنای تغییر واقعی توان دستگاه نیست.
بازه زمانی محاسبه بسیار مهم است
یکی از بزرگترین اشتباهها مقایسه دو عددی است که بازه زمانی یکسانی ندارند.
برای مثال:
هشریت لحظهای دستگاه:
200 TH/s
هشریت 5 دقیقهای Pool:
170 TH/s
این مقایسه بهتنهایی اطلاعات کافی ارائه نمیدهد.
برای ارزیابی بهتر باید میانگینهای طولانیتر بررسی شوند.
معمولاً:
- 5 دقیقه → مناسب برای تشخیص سریع تغییر
- 1 ساعت → مناسب برای بررسی عملکرد کوتاهمدت
- 24 ساعت → مناسبتر برای ارزیابی واقعی عملکرد
هرچه بازه زمانی طولانیتر باشد، تأثیر نوسان تصادفی Shareها کمتر میشود.
چه اختلافی طبیعی است؟
یک عدد ثابت برای تمام دستگاهها وجود ندارد.
تلرانس سازنده، مدل ماینر، Firmware، تنظیمات، شرایط محیط و روش محاسبه استخر همگی اثر دارند.
اما بهطور کلی:
اگر دستگاه دارای مشخصات:
200 TH/s
باشد و میانگین طولانیمدت آن مثلاً:
196 TH/s
باشد، الزاماً مشکلی وجود ندارد.
اما اگر میانگین 24 ساعته دستگاه برای مدت طولانی روی:
160 TH/s
قرار گرفته باشد، احتمالاً نیاز به بررسی وجود دارد.
نکته مهم این است که تصمیم نباید براساس یک Snapshot گرفته شود.
دلیل اول: تلرانس طبیعی سختافزار
دو ماینر کاملاً یکسان الزاماً دقیقاً عملکرد یکسان ندارند.
در ساخت چیپهای ASIC تفاوتهای بسیار کوچکی در ویژگیهای الکتریکی وجود دارد.
به همین دلیل ممکن است دو دستگاه از یک مدل:
یکی:
202 TH/s
و دیگری:
196 TH/s
فعالیت کنند.
هر دو میتوانند در محدوده طبیعی مشخصات دستگاه باشند.
این موضوع در صنعت نیمههادی کاملاً عادی است.
دلیل دوم: دمای بالا
دمای تجهیزات یکی از مهمترین عوامل تأثیرگذار بر هشریت واقعی است.
اگر دمای ASIC یا هشبرد از محدوده طراحیشده بالاتر رود، Firmware ممکن است برای محافظت از دستگاه:
- فرکانس را کاهش دهد؛
- توان مصرفی را محدود کند؛
- بخشی از ASICها را از مدار خارج کند؛
- یا دستگاه را Restart کند.
نتیجه میتواند کاهش هشریت باشد.
مثال
یک ماینر ممکن است در شرایط مناسب:
200 TH/s
تولید کند.
اما با افزایش دما به دلیل تهویه نامناسب، عملکرد آن به:
185 TH/s
کاهش پیدا کند.
در چنین حالتی مشکل از استخر نیست؛ دستگاه واقعاً هشریت کمتری تولید میکند.
دلیل سوم: یک هشبرد بهدرستی کار نمیکند
بسیاری از ماینرهای ASIC دارای چند Hashboard هستند.
فرض کنیم ماینری سه هشبرد داشته باشد و هر برد تقریباً یکسوم توان دستگاه را تولید کند.
اگر یکی از بردها از مدار خارج شود، دستگاه ممکن است همچنان:
- Online باشد؛
- به Pool متصل باشد؛
- Share ارسال کند؛
- و در شبکه Ping شود.
اما هشریت آن ممکن است تقریباً یکسوم کاهش پیدا کند.
این نمونه خوبی است از اینکه چرا Online بودن دستگاه به معنای سالم بودن کامل آن نیست.
دلیل چهارم: برخی ASIC Chipها فعال نیستند
مشکل همیشه به معنای از دست رفتن کامل یک هشبرد نیست.
ممکن است فقط تعدادی از ASICهای یک برد دچار مشکل شوند.
در چنین شرایطی کاهش هشریت میتواند تدریجیتر باشد.
برای مثال:
هشریت اسمی:
200 TH/s
عملکرد واقعی:
184 TH/s
ممکن است در ظاهر دستگاه همچنان عادی به نظر برسد، اما بررسی تعداد Chipها یا Kernel Log نشان دهد بخشی از ASICها شناسایی نشدهاند.
دلیل پنجم: مشکل پاور
هشریت بالا به تأمین انرژی پایدار وابسته است.
اگر Power Supply نتواند توان مورد نیاز دستگاه را بهدرستی تأمین کند، ممکن است مشکلاتی مانند این ایجاد شوند:
- افت هشریت
- ناپایداری هشبرد
- Restart
- خطای ولتاژ
- خاموششدن Chain
- تغییر فرکانس
گاهی دستگاه روشن است اما تحت بار کامل عملکرد پایداری ندارد.
در چنین شرایطی بررسی PSU و ولتاژ ورودی اهمیت زیادی دارد.
دلیل ششم: ولتاژ یا برق ورودی نامناسب
مشکل همیشه داخل خود ماینر نیست.
در فارمهای بزرگ، موارد زیر میتوانند روی عملکرد تجهیزات اثر بگذارند:
- افت ولتاژ
- عدم تعادل فازها
- کابل نامناسب
- اتصالات ضعیف
- PDU نامناسب
- داغ شدن کابل یا کانکتور
- ظرفیت ناکافی مدار
اگر چند ماینر در یک بخش از فارم همزمان دچار افت عملکرد شوند، باید زیرساخت مشترک آن بخش نیز بررسی شود.
دلیل هفتم: تنظیمات Power Mode
بسیاری از ماینرهای جدید چند حالت کاری دارند.
برای مثال:
Low Power Mode
مصرف برق کمتر، هشریت کمتر.
Normal Mode
عملکرد استاندارد.
High Performance Mode
هشریت بیشتر با مصرف و گرمای بالاتر.
اگر دستگاه در حالت Low Power قرار گرفته باشد، مقایسه آن با هشریت Nominal حالت استاندارد اشتباه است.
قبل از عیبیابی باید Mode فعلی دستگاه مشخص شود.
دلیل هشتم: Firmware متفاوت
Firmware میتواند تأثیر زیادی روی عملکرد ASIC داشته باشد.
نسخههای مختلف ممکن است دارای:
- الگوریتم Auto-tuning متفاوت
- Power Limit متفاوت
- کنترل حرارتی متفاوت
- فرکانس متفاوت
- تنظیمات ولتاژ متفاوت
باشند.
به همین دلیل دو دستگاه با سختافزار یکسان اما Firmware متفاوت ممکن است هشریت یکسانی نداشته باشند.
دلیل نهم: Auto-Tuning
برخی Firmwareها برای رسیدن به بهترین ترکیب میان هشریت، مصرف انرژی و پایداری، هر ASIC یا Hashboard را بهصورت خودکار تنظیم میکنند.
این فرآیند ممکن است مدتی طول بکشد.
پس از Boot ممکن است دستگاه در ابتدا:
170 TH/s
و بعد از تکمیل Tuning:
198 TH/s
نمایش دهد.
بنابراین اندازهگیری بلافاصله بعد از روشنشدن دستگاه میتواند گمراهکننده باشد.
دلیل دهم: Overclock و Underclock
برخی فارمها تجهیزات را با تنظیمات غیرپیشفرض اجرا میکنند.
Overclock
هشریت افزایش پیدا میکند اما معمولاً:
- مصرف برق بیشتر میشود؛
- دما افزایش پیدا میکند؛
- فشار روی سختافزار بیشتر میشود.
Underclock
هشریت کاهش پیدا میکند اما میتواند:
- مصرف انرژی را کاهش دهد؛
- راندمان J/TH را بهبود دهد؛
- گرمای کمتری تولید کند.
بنابراین همیشه هشریت بالاتر به معنی عملکرد بهتر اقتصادی نیست.
دلیل یازدهم: Reject Share
ممکن است دستگاه هشریت مناسبی تولید کند اما بخشی از Shareهای آن توسط استخر پذیرفته نشوند.
فرض کنیم دستگاه از نظر محلی عملکرد طبیعی دارد:
200 TH/s
اما درصد قابل توجهی از Shareها Reject میشوند.
در این حالت Hashrate سمت Pool میتواند کمتر از انتظار باشد.
دلایل Reject ممکن است شامل:
- شبکه ناپایدار
- Stale Share
- اختلال ارتباطی
- مشکل Stratum
- تنظیمات
- یا Hardware Error
باشد.
Accepted Hashrate از هشریت خام مهمتر است
برای درآمد واقعی از Pool مهم نیست دستگاه چند محاسبه را انجام داده؛ مهم این است که چه مقدار از کاری که انجام داده به Share معتبر تبدیل شده و توسط استخر پذیرفته شده است.
به همین دلیل دستگاهی با:
200 TH/s Local
اما Reject بالا ممکن است عملکرد اقتصادی بدتری از دستگاهی با:
195 TH/s
و اتصال کاملاً پایدار داشته باشد.
از این دیدگاه، صرفاً تعقیب بالاترین عدد Local Hashrate کافی نیست.
دلیل دوازدهم: Stale Share
Stale Share زمانی رخ میدهد که Share دیر به استخر برسد و در زمان دریافت دیگر مربوط به Job فعلی نباشد.
دلایل معمول:
- Latency بالا
- Packet Loss
- اتصال ناپایدار
- مسیر شبکه نامناسب
- انتقال مکرر میان Poolها
- اختلال اینترنت
هستند.
افزایش Stale میتواند باعث شود Hashrate سمت Pool کمتر از Hashrate محلی به نظر برسد.
دلیل سیزدهم: قطعیهای کوتاه شبکه
یکی از مشکلاتی که بهراحتی دیده نمیشود، قطعیهای بسیار کوتاه است.
فرض کنیم ماینر هر چند ساعت فقط برای 30 ثانیه اتصال خود را از دست بدهد.
ممکن است کاربر هنگام باز کردن پنل دستگاه هیچ مشکلی مشاهده نکند، چون ماینر دوباره Online شده است.
اما در طول 24 ساعت مجموع این قطعیها میتواند روی هشریت Pool-side اثر بگذارد.
به همین دلیل تاریخچه Connection و Uptime اهمیت دارد.
دلیل چهاردهم: Failover بین Poolها
اگر چند Pool روی دستگاه تعریف شده باشد، در صورت بروز مشکل ماینر ممکن است از Pool اول به Pool دوم منتقل شود.
در این حالت ممکن است:
Local Hashrate طبیعی باشد،
اما در پنل Pool اصلی کاهش مشاهده شود.
علت بسیار ساده است:
دستگاه بخشی از زمان را روی Pool دیگری استخراج کرده است.
بنابراین سیستم مانیتورینگ بهتر است علاوه بر هشریت، Pool فعال فعلی را نیز مشخص کند.
دلیل پانزدهم: Restartهای مکرر
ماینری که مرتباً Restart میشود ممکن است زمانی که مشاهده میشود کاملاً سالم به نظر برسد.
اما هر Restart شامل دورهای است که:
- دستگاه Boot میشود؛
- Firmware راهاندازی میشود؛
- Hashboardها شناسایی میشوند؛
- ارتباط Pool برقرار میشود؛
- و استخراج به حالت پایدار میرسد.
اگر این اتفاق چندین بار در روز رخ دهد، میانگین هشریت پایین میآید.
به همین دلیل بررسی Restart Count و Uptime اهمیت دارد.
دلیل شانزدهم: تفاوت روش محاسبه نرمافزارها
دو نرمافزار ممکن است حتی با داده یکسان اعداد متفاوتی نمایش دهند.
برای مثال:
یک سیستم:
میانگین 5 دقیقه
و دیگری:
میانگین 15 دقیقه
را نمایش دهد.
یا ممکن است یکی میانگین ساده و دیگری میانگین وزندار محاسبه کند.
بنابراین قبل از مقایسه دو داشبورد باید مشخص باشد هر عدد چگونه محاسبه شده است.
چگونه بفهمیم افت هشریت واقعی است؟
بهترین روش بررسی چند شاخص در کنار یکدیگر است.
مرحله اول: میانگین طولانیتر را نگاه کنید
بر اساس یک عدد لحظهای تصمیم نگیرید.
میانگین:
- 1 ساعت
- و 24 ساعت
را بررسی کنید.
مرحله دوم: Local Hashrate را بررسی کنید
اگر Local Hashrate نیز پایین است، احتمالاً مشکل در خود دستگاه یا شرایط عملیاتی آن است.
موارد زیر را بررسی کنید:
- دما
- Hashboard
- ASIC
- PSU
- Power Mode
- Firmware
- Fan
مرحله سوم: Pool-side Hashrate را بررسی کنید
اگر Local طبیعی است اما Pool-side پایینتر است، بیشتر روی موارد زیر تمرکز کنید:
- Reject
- Stale
- Latency
- Packet Loss
- Pool Connection
- Failover
- Restart
- شبکه
یک روش ساده برای تشخیص محل مشکل
این الگو میتواند در عیبیابی مفید باشد:
| وضعیت | احتمال بیشتر |
|---|---|
| Local پایین + Pool پایین | مشکل دستگاه یا زیرساخت فارم |
| Local طبیعی + Pool پایین | شبکه، Reject یا Pool |
| Local بالا + Accepted پایین | Reject / Stale / ارتباط |
| هشریت پایین + دمای بالا | Cooling یا محیط |
| هشریت پایین + یک Hashboard غایب | مشکل Hashboard |
| چند ماینر همزمان افت کردند | زیرساخت مشترک |
| فقط یک ماینر افت کرده | خود دستگاه |
| Hashrate خوب ولی Restart زیاد | ناپایداری برق/پاور/Firmware |
این جدول جای عیبیابی فنی کامل را نمیگیرد اما نقطه شروع بسیار خوبی است.
مقایسه با دستگاههای مشابه بسیار مفید است
فرض کنیم در یک سالن 50 دستگاه از یک مدل وجود دارند.
48 دستگاه میانگین:
198–202 TH/s
دارند.
اما دو دستگاه:
165 TH/s
نشان میدهند.
این مقایسه فوراً مشخص میکند که شرایط دو دستگاه غیرعادی است.
به همین دلیل یکی از قابلیتهای مهم مانیتورینگ فارم، مقایسه تجهیزات هممدل است.
Baseline چیست؟
Baseline یعنی رفتار طبیعی و مورد انتظار یک دستگاه یا گروه از تجهیزات.
به جای تعیین یک Threshold یکسان برای تمام ماینرها، میتوان رفتار معمول هر مدل را شناخت.
برای مثال:
مدل A:
195–205 TH/s
مدل B:
115–122 TH/s
مدل C:
330–345 TH/s
اگر عملکرد دستگاه از محدوده معمول مدل خود خارج شود، سیستم میتواند هشدار ایجاد کند.
این روش در فارمهای بزرگ بسیار مؤثرتر از یک قانون عمومی برای همه تجهیزات است.
هشریت پایین همیشه بد نیست
یک نکته مهم دیگر:
بالاترین Hashrate الزاماً بهترین حالت کاری نیست.
فرض کنیم:
حالت اول
210 TH/s
مصرف:
4000 W
حالت دوم
195 TH/s
مصرف:
3200 W
ممکن است حالت دوم از نظر اقتصادی و راندمان انرژی بهتر باشد.
برای ارزیابی درست باید شاخص:
J/TH
نیز بررسی شود.
بنابراین Hashrate باید در کنار مصرف برق دیده شود.
هشریت و Efficiency را با هم مانیتور کنید
فرض کنیم دستگاهی همیشه:
200 TH/s
با مصرف:
3500 W
کار کرده است.
راندمان تقریبی آن:
17.5 J/TH
است.
اگر بعداً همان دستگاه:
175 TH/s
تولید کند اما مصرف همچنان تقریباً:
3500 W
باقی بماند، راندمان واقعی به:
20 J/TH
بدتر شده است.
در چنین حالتی مشکل فقط 25 TH/s هشریت ازدسترفته نیست.
دستگاه اکنون برای هر واحد پردازش انرژی بیشتری مصرف میکند.
نقش تاریخچه در تشخیص مشکلات
اگر فقط وضعیت فعلی دستگاه را ببینیم، بسیاری از مشکلات قابل تشخیص نیستند.
فرض کنید امروز دستگاه:
185 TH/s
نشان میدهد.
بدون تاریخچه نمیدانیم:
- همیشه همینطور بوده؟
- دیروز 200 TH/s بوده؟
- افت ناگهانی اتفاق افتاده؟
- طی یک ماه آرامآرام کاهش یافته؟
نمودارهای تاریخی پاسخ این پرسشها را مشخص میکنند.
افت ناگهانی
معمولاً به مشکلاتی مانند:
- Hashboard
- PSU
- Restart
- Configuration
نزدیکتر است.
افت تدریجی
ممکن است با:
- افزایش دما
- گردوغبار
- خرابی تدریجی فن
- فرسودگی سختافزار
مرتبط باشد.
چه زمانی هشدار Low Hashrate ایجاد کنیم؟
قرار دادن Threshold بسیار نزدیک به هشریت اسمی میتواند هشدارهای غیرضروری زیادی تولید کند.
مثلاً برای دستگاه 200 TH/s اگر Threshold روی:
199 TH/s
قرار گیرد، احتمال ایجاد Alertهای مکرر زیاد است.
روش بهتر میتواند استفاده از درصد باشد.
برای مثال:
Warning:
کمتر از 90 درصد ظرفیت مورد انتظار
Critical:
کمتر از 75 یا 80 درصد
البته مقدار دقیق باید براساس مدل دستگاه و شرایط فارم تنظیم شود.
هشدار باید مدتزمان نیز داشته باشد
فرض کنیم Hashrate فقط برای 30 ثانیه کاهش پیدا کند.
لزومی ندارد فوراً Alert Critical ارسال شود.
روش حرفهایتر این است که شرطی مانند این تعریف شود:
Hashrate < Threshold for 5 minutes
یعنی فقط اگر افت برای مدت مشخص ادامه داشت هشدار ارسال شود.
این کار از تولید Alertهای غیرضروری جلوگیری میکند.
تشخیص مشکل در سطح فارم
در یک فارم بزرگ فقط بررسی تکتک دستگاهها کافی نیست.
سیستم باید بتواند الگوها را پیدا کند.
برای مثال:
تمام ماینرهای یک سالن افت کردهاند
احتمالاً:
- دمای سالن
- برق
- تهویه
- یا شبکه
مشکل دارد.
تمام دستگاههای یک Switch افت Pool-side دارند
احتمال مشکل شبکه بیشتر است.
تمام ماینرهای یک مدل افت دارند
ممکن است Firmware یا تنظیم مشترک مشکل داشته باشد.
فقط یک ماینر مشکل دارد
احتمالاً باید خود دستگاه بررسی شود.
این نوع تحلیل یکی از تفاوتهای اصلی میان «نمایش اطلاعات» و مانیتورینگ واقعی فارم است.
چه اطلاعاتی کنار هشریت نمایش داده شوند؟
برای اینکه Hashrate معنای بیشتری داشته باشد، بهتر است هنگام بررسی دستگاه اطلاعات زیر نیز در دسترس باشند:
- Model
- Expected Hashrate
- Current Hashrate
- 1h Average
- 24h Average
- Pool-side Hashrate
- Reject %
- Temperature
- Fan RPM
- Hashboard Count
- ASIC Status
- Power
- Efficiency
- Uptime
- Active Pool
- Last Restart
این مجموعه اطلاعات معمولاً برای شروع عیبیابی بسیار مفید است.
داشبورد باید استثناها را نشان دهد، نه فقط دادهها را
در فارمی با 5000 دستگاه، مدیر مجموعه نمیتواند دائماً 5000 عدد Hashrate را بررسی کند.
یک داشبورد مناسب باید ابتدا دستگاههایی را نشان دهد که از رفتار طبیعی خارج شدهاند.
برای مثال:
Normal: 4,821
Low Hashrate: 91
Offline: 43
High Temperature: 28
High Reject: 17
مدیر میتواند مستقیماً روی همان 179 دستگاه مشکلدار تمرکز کند.
این رویکرد مقیاسپذیری مدیریت فارم را بسیار افزایش میدهد.
Local و Pool باید مکمل هم باشند
یکی از مهمترین نکات در تحلیل هشریت این است که Local و Pool رقیب یکدیگر نیستند.
هرکدام بخشی از واقعیت را نشان میدهند.
Local Hashrate میگوید:
خود سختافزار چه مقدار پردازش گزارش میکند؟
Pool-side Hashrate میگوید:
چه مقدار از این فعالیت در سمت استخر به شکل Share مشاهده شده است؟
کنار هم قرار دادن این دو مقدار تصویر بسیار کاملتری ایجاد میکند.
نتیجهگیری
اختلاف میان هشریت اسمی، هشریت دستگاه و هشریت استخر در بسیاری از مواقع کاملاً طبیعی است.
مشکل زمانی مطرح میشود که اختلاف:
- قابل توجه باشد؛
- در مدت طولانی ادامه پیدا کند؛
- نسبت به عملکرد قبلی دستگاه تغییر محسوسی داشته باشد؛
- یا همراه با شاخصهای دیگری مانند دمای بالا، Reject، Restart یا خطای Hashboard باشد.
بنابراین برای ارزیابی صحیح یک ماینر نباید فقط یک عدد را مشاهده کرد.
بهترین روش این است که موارد زیر کنار یکدیگر بررسی شوند:
هشریت اسمی + Local Hashrate + Pool-side Hashrate + میانگین زمانی + Reject + دما + Hashboard + Uptime + مصرف انرژی
این اطلاعات کمک میکنند مشخص شود آیا با یک نوسان طبیعی روبهرو هستیم یا واقعاً بخشی از ظرفیت دستگاه از دست رفته است.
در فارمهای بزرگ، حتی چند درصد افت عملکرد اگر روی تعداد زیادی ماینر تکرار شود میتواند به مقدار قابل توجهی هشریت ازدسترفته تبدیل شود.
به همین دلیل تشخیص سریع فاصله میان عملکرد واقعی و ظرفیت مورد انتظار، یکی از مهمترین وظایف سیستم مانیتورینگ فارم است.