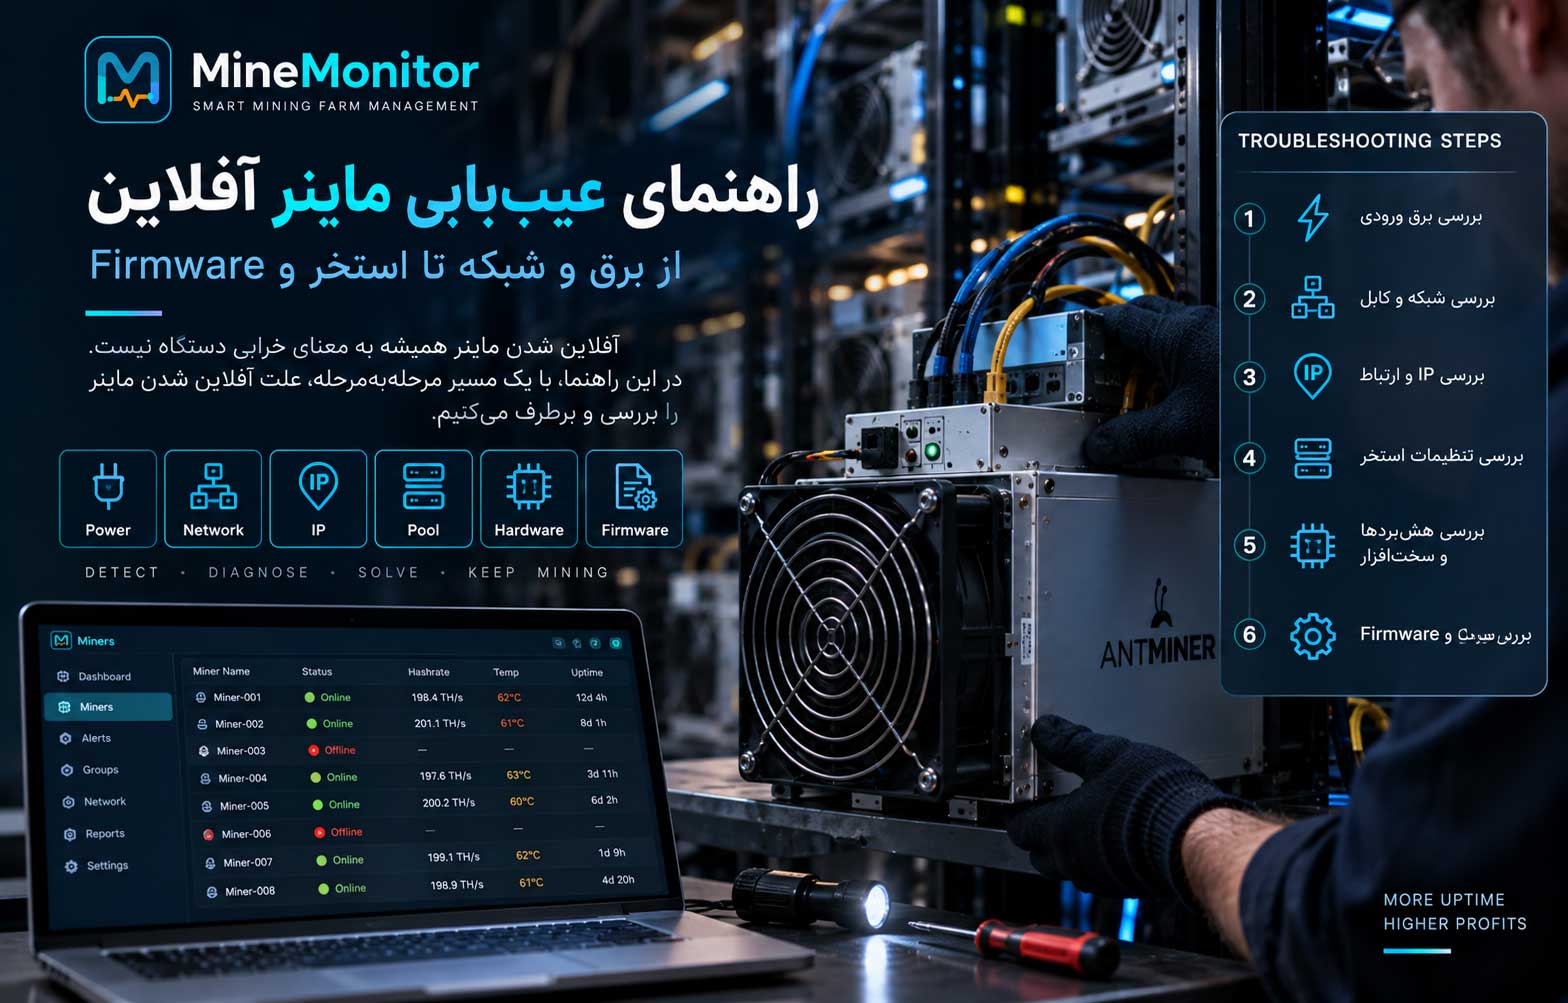
راهنمای عیبیابی ماینر آفلاین؛ از برق و شبکه تا استخر و Firmware
آفلاین شدن یک ماینر یکی از رایجترین مشکلات عملیاتی در فارمهای استخراج است.
اما عبارت «ماینر آفلاین است» بهتنهایی اطلاعات زیادی در اختیار ما قرار نمیدهد.
ممکن است دستگاه:
- کاملاً خاموش شده باشد؛
- روشن باشد اما در شبکه دیده نشود؛
- از طریق IP در دسترس باشد اما استخراج نکند؛
- استخراج کند اما در استخر Offline نمایش داده شود؛
- مرتباً Restart شود؛
- یا فقط ارتباط آن با Pool قطع شده باشد.
هرکدام از این شرایط منشأ متفاوتی دارند.
به همین دلیل بهترین روش عیبیابی این نیست که مستقیماً سراغ باز کردن دستگاه برویم. باید مرحلهبهمرحله مشخص کنیم مشکل در کدام لایه قرار دارد: برق، سختافزار، شبکه، Firmware یا استخر.
ابتدا مشخص کنید «Offline» دقیقاً یعنی چه
قبل از هر اقدامی باید مشخص شود دستگاه در کدام وضعیت قرار دارد.
حالت اول: دستگاه کاملاً خاموش است
هیچ فن، چراغ یا نشانهای از فعالیت وجود ندارد.
در این حالت بررسی باید از برق شروع شود.
حالت دوم: دستگاه روشن است اما IP آن در دسترس نیست
فنها کار میکنند اما:
- Ping پاسخ نمیدهد؛
- Web Panel باز نمیشود؛
- نرمافزار مانیتورینگ دستگاه را نمیبیند.
در این حالت شبکه یا Controller مظنون اصلی است.
حالت سوم: صفحه ماینر باز میشود اما Hashrate صفر است
دستگاه از نظر شبکه Online است اما استخراج انجام نمیشود.
در این حالت باید مواردی مانند:
- Hashboard
- Firmware
- Pool
- دما
- پاور
بررسی شوند.
حالت چهارم: ماینر Hashrate دارد اما Pool آن را Offline نشان میدهد
این وضعیت بیشتر به موارد زیر مربوط میشود:
- تنظیمات Pool
- Worker
- DNS
- اینترنت
- Stratum
- Failover
- Reject یا ارتباط ناپایدار
پس اولین مرحله عیبیابی همیشه تعریف دقیق نوع Offline بودن است.
یک قانون مهم: از لایه سادهتر شروع کنید
در عیبیابی حرفهای بهتر است از محتملترین و سادهترین علتها شروع کنیم.
ترتیب منطقی میتواند این باشد:
برق → وضعیت فیزیکی → شبکه → IP → پنل دستگاه → Firmware → Hashboard → Pool → اینترنت
این روش باعث میشود برای یک مشکل ساده شبکه، دستگاه بدون دلیل باز نشود.
مرحله اول: برق ورودی را بررسی کنید
اگر دستگاه کاملاً خاموش است، اولین بررسی باید برق باشد.
موارد زیر را کنترل کنید:
- برق ورودی وجود دارد؟
- Breaker قطع نشده؟
- فیوز سالم است؟
- PDU فعال است؟
- کابل برق متصل است؟
- کانکتور آسیب ندیده؟
- PSU روشن میشود؟
- ولتاژ ورودی مناسب است؟
گاهی مشکل خود ماینر نیست و یک بخش کامل از فارم برق ندارد.
اگر چند دستگاه همزمان خاموش شدهاند چه؟
این یکی از مهمترین سرنخهاست.
اگر فقط یک دستگاه خاموش شده باشد، احتمال خرابی همان دستگاه بیشتر است.
اما اگر مثلاً:
12 ماینر یک Rack
همزمان Offline شوند، احتمال اینکه هر 12 دستگاه همزمان خراب شده باشند بسیار پایین است.
در این حالت باید ابتدا تجهیزات مشترک بررسی شوند:
- فیوز
- PDU
- تابلو برق
- فاز
- کابل تغذیه
- Switch
- Uplink شبکه
همین الگو در عیبیابی فارم بسیار ارزشمند است.
مرحله دوم: وضعیت پاور یا PSU
ماینر ممکن است برق ورودی داشته باشد اما Power Supply نتواند دستگاه را بهدرستی راهاندازی کند.
نشانههای احتمالی مشکل پاور:
- دستگاه کاملاً روشن نمیشود؛
- مرتباً خاموش و روشن میشود؛
- هشبردها شناسایی نمیشوند؛
- Hashrate بعد از مدتی صفر میشود؛
- دستگاه زیر بار Restart میکند؛
- خطای ولتاژ در Log دیده میشود.
پاور معیوب همیشه بهصورت «کاملاً خاموش» ظاهر نمیشود.
گاهی PSU در حالت کمبار کار میکند اما زمانی که Hashboardها شروع به فعالیت میکنند ناپایدار میشود.
مرحله سوم: چراغهای وضعیت دستگاه را نگاه کنید
مدلهای مختلف ASIC دارای LEDهای متفاوتی هستند.
معمولاً چراغها میتوانند اطلاعاتی درباره موارد زیر ارائه دهند:
- Power
- Normal Operation
- Fault
- Network
- Alarm
اما معنی LEDها بین مدلها متفاوت است.
بنابراین در تشخیص دقیق باید راهنمای همان مدل ماینر بررسی شود.
مهمتر از رنگ خاص LED، این است که مشخص شود آیا دستگاه فرآیند Boot را کامل کرده یا در یکی از مراحل متوقف شده است.
مرحله چهارم: کابل شبکه را بررسی کنید
اگر دستگاه روشن است اما در شبکه دیده نمیشود، کابل شبکه یکی از اولین مواردی است که باید کنترل شود.
بررسی کنید:
- کابل بهدرستی متصل است؟
- کانکتور RJ45 سالم است؟
- Link LED روشن است؟
- کابل آسیب فیزیکی ندارد؟
- پورت Switch فعال است؟
یک کابل معیوب میتواند باعث شود دستگاه از دید مانیتورینگ کاملاً Offline شود، در حالی که خود ماینر کاملاً روشن است.
مرحله پنجم: پورت Switch را بررسی کنید
اگر کابل سالم به نظر میرسد، وضعیت Switch را بررسی کنید.
سؤالات مهم:
- Link Up است؟
- Port Error وجود دارد؟
- پورت Disable نشده؟
- VLAN صحیح است؟
- MAC Address دستگاه دیده میشود؟
- پورت Flapping ندارد؟
در فارمهای بزرگ بررسی Switch میتواند اطلاعات بسیار ارزشمندی ارائه دهد.
اگر ماینر از نظر برق فعال است ولی هیچ MAC Address روی پورت دیده نمیشود، احتمالاً مشکل در کابل، پورت شبکه دستگاه یا Controller وجود دارد.
مرحله ششم: آیا IP ماینر تغییر کرده است؟
یکی از مشکلات رایج مخصوصاً در شبکههایی که DHCP استفاده میکنند، تغییر IP دستگاه است.
ممکن است شما تصور کنید:
192.168.10.125
Offline شده است.
در حالی که همان ماینر اکنون IP دیگری مانند:
192.168.10.187
دریافت کرده باشد.
بنابراین باید:
- DHCP Lease
- ARP Table
- MAC Address
- IP Scanner
بررسی شوند.
در فارمهای بزرگ بهتر است مدیریت IP ساختاریافته باشد تا پیدا کردن دستگاهها دشوار نشود.
IP ثابت بهتر است یا DHCP؟
هر دو روش میتوانند درست باشند.
اما در فارم بزرگ معمولاً ساختار مدیریتشده اهمیت بیشتری از نوع روش دارد.
میتوان از:
Static IP
یا
DHCP Reservation
استفاده کرد.
مزیت DHCP Reservation این است که IP براساس MAC Address به دستگاه اختصاص داده میشود و مدیریت مرکزی سادهتر است.
مهم این است که IP دستگاه بدون اطلاع سیستم مدیریت تغییر نکند.
مرحله هفتم: Ping بگیرید
اگر IP دستگاه را میدانید، Ping یک تست سریع اولیه است.
اگر Ping پاسخ میدهد:
- کابل احتمالاً برقرار است؛
- Switch مسیر شبکه دارد؛
- Interface دستگاه فعال است.
اما پاسخ دادن Ping به معنی سالم بودن کامل ماینر نیست.
ممکن است:
Ping = OK
ولی:
Hashrate = 0
باشد.
Ping فقط نشان میدهد یک بخش از ارتباط IP برقرار است.
اگر Ping پاسخ نمیدهد چه؟
دلایل ممکن:
- دستگاه خاموش است؛
- IP عوض شده؛
- کابل قطع است؛
- Switch مشکل دارد؛
- VLAN اشتباه است؛
- Controller هنگ کرده؛
- IP Conflict وجود دارد؛
- Interface شبکه دستگاه مشکل دارد.
نباید بلافاصله نتیجه گرفت که Miner Board خراب شده است.
مرحله هشتم: IP Conflict را فراموش نکنید
اگر دو دستگاه یک IP یکسان داشته باشند، رفتار شبکه میتواند بسیار عجیب شود.
نشانههای احتمالی:
- دستگاه گاهی Online و گاهی Offline است؛
- Web Panel یکبار باز میشود و بار دیگر نه؛
- MAC Address مرتبط با IP تغییر میکند؛
- Ping ناپایدار میشود.
در شبکه فارم بهتر است برای جلوگیری از این مشکل IPها بهصورت ساختاریافته مدیریت شوند.
مرحله نهم: Web Panel ماینر را باز کنید
اگر Ping پاسخ میدهد، مرحله بعد ورود به صفحه مدیریتی دستگاه است.
بررسی کنید:
- صفحه Login باز میشود؟
- Dashboard لود میشود؟
- Hashrate وجود دارد؟
- Hashboardها شناسایی شدهاند؟
- Fanها فعالاند؟
- دما طبیعی است؟
- Pool متصل است؟
- Uptime چقدر است؟
همین صفحه معمولاً مشخص میکند مشکل بیشتر سختافزاری است یا ارتباطی.
صفحه دستگاه باز میشود اما Hashrate صفر است
در این حالت شبکه تا خود ماینر سالم است.
حالا باید سمت داخلی دستگاه را بررسی کنیم.
موارد مهم:
- Hashboard Detection
- ASIC Count
- Temperature
- PSU
- Kernel Log
- Miner Process
- Pool Connection
وجود Web Panel با Hashrate صفر یکی از بهترین نشانهها برای محدود کردن محدوده عیبیابی است.
مرحله دهم: Uptime را بررسی کنید
Uptime یکی از سادهترین و ارزشمندترین شاخصهای عیبیابی است.
فرض کنید ماینر Offline گزارش شده و بعد از ورود به پنل میبینید:
Uptime: 4 minutes
این نشان میدهد دستگاه بهتازگی Restart شده است.
اگر این اتفاق مرتباً رخ دهد باید علت Restart پیدا شود.
دلایل رایج:
- برق
- PSU
- Overheat
- Firmware
- Watchdog
- Hardware Error
Restartهای کوتاه را جدی بگیرید
یکی از مشکلات پنهان فارم این است که دستگاه ممکن است خودش دوباره Online شود.
مثلاً:
12:00 → Offline
12:03 → Online
اپراتور ساعت 12:10 وضعیت را میبیند و تصور میکند همهچیز سالم است.
اما اگر این اتفاق روزانه 20 بار رخ دهد، دستگاه مقدار قابل توجهی Downtime دارد.
سیستم مانیتورینگ باید تاریخچه Online/Offline و Restart را ذخیره کند.
مرحله یازدهم: Kernel Log را بررسی کنید
در بسیاری از ASICها Kernel Log اطلاعات بسیار مهمی درباره علت مشکل ارائه میدهد.
مواردی که ممکن است دیده شوند:
- Hashboard not found
- ASIC missing
- Fan lost
- Temperature too high
- Power voltage error
- Network error
- Pool connection failure
- Watchdog restart
البته متن دقیق خطا به مدل و Firmware وابسته است.
Kernel Log را باید براساس زمان رخداد نیز بررسی کرد.
آخرین خطاهای قبل از Restart معمولاً اهمیت بیشتری دارند.
مرحله دوازدهم: دمای دستگاه را کنترل کنید
دمای بیش از حد میتواند باعث خاموششدن حفاظتی ماینر شود.
این موضوع مخصوصاً در فصل گرم، تهویه نامناسب یا گرفتگی مسیر هوا اهمیت دارد.
بررسی کنید:
- Intake Temperature
- Chip Temperature
- Board Temperature
- Fan RPM
در صورت افزایش بیش از حد دما، Firmware ممکن است:
- Hashing را متوقف کند؛
- فرکانس را کاهش دهد؛
- دستگاه را Restart کند؛
- یا وارد Protection Mode شود.
اگر چند ماینر یک سالن همزمان Overheat شوند
در این حالت احتمال خرابی تکتک دستگاهها کمتر است.
باید شرایط محیط بررسی شود:
- Exhaust Fan
- ورودی هوا
- Hot Air Recirculation
- فیلترها
- دمای محیط
- فشار هوا
مانیتورینگ گروهی کمک میکند سریع مشخص شود مشکل محلی است یا زیرساختی.
مرحله سیزدهم: Fanها را بررسی کنید
خرابی یک فن میتواند مانع شروع استخراج شود.
موارد قابل بررسی:
- RPM
- Fan Lost Error
- Fan Speed Difference
- Physical Rotation
- Connector
بعضی Firmwareها در صورت شناسایی نبود فن یا RPM غیرطبیعی، برای محافظت دستگاه اجازه Hashing نمیدهند.
مرحله چهاردهم: Hashboardها را بررسی کنید
اگر دستگاه Online است اما Hashrate ندارد یا بسیار پایین است، وضعیت Hashboardها اهمیت دارد.
مثلاً دستگاهی که باید سه برد داشته باشد ممکن است فقط:
Chain 0
و
Chain 1
را شناسایی کند.
در این حالت Chain سوم مشکل دارد.
دلایل میتواند شامل:
- کابل Data
- کابل Power
- Hashboard
- PSU
- Controller
- Temperature
باشد.
اگر هیچ Hashboard شناسایی نمیشود
وقتی Controller فعال است ولی هیچ Hashboard شناسایی نمیشود، باید موارد مشترک بررسی شوند.
مثلاً:
- PSU
- کابلهای ارتباطی
- Control Board
- Firmware
- Power Rail
وجود همزمان مشکل در تمام بردها گاهی نشان میدهد منشأ خطا یک بخش مشترک است.
مرحله پانزدهم: Pool Configuration
ممکن است دستگاه کاملاً سالم باشد اما هیچ استخراجی انجام نشود زیرا Pool اشتباه تنظیم شده است.
بررسی کنید:
- Stratum URL
- Port
- Worker
- Username
- Password
- Pool Priority
حتی یک اشتباه ساده تایپی میتواند مانع اتصال شود.
Worker اشتباه
در بعضی Poolها Worker به شکل:
account.worker01
تعریف میشود.
اگر نام حساب یا Worker اشتباه باشد، ممکن است:
- اتصال رد شود؛
- Shareها ثبت نشوند؛
- یا دستگاه در حساب مورد انتظار دیده نشود.
بنابراین تنظیم Worker نیز باید بررسی شود.
مرحله شانزدهم: آیا Pool در دسترس است؟
اگر چند دستگاه همزمان ارتباط با یک Pool خاص را از دست دادهاند، ممکن است مشکل از خود ماینرها نباشد.
بررسی کنید:
- DNS Resolution
- Route
- Port Accessibility
- Stratum Endpoint
- اینترنت
اگر دستگاهها روی Backup Pool کار میکنند ولی Primary Pool قطع است، احتمالاً مشکل به مسیر ارتباطی مربوط است.
Failover را بررسی کنید
بسیاری از ماینرها چند Pool دارند.
مثلاً:
Pool 1
Pool 2
Pool 3
اگر Pool 1 قابل دسترس نباشد، ماینر میتواند به Pool 2 منتقل شود.
در نتیجه ممکن است:
ماینر در Pool اصلی Offline باشد
اما در واقع همچنان در حال استخراج روی Pool Backup باشد.
به همین دلیل مانیتورینگ باید Active Pool را نیز نمایش دهد.
مرحله هفدهم: DNS
برخی تنظیمات Stratum از Domain استفاده میکنند.
مثلاً:
btc.example.com
اگر DNS دستگاه یا شبکه مشکل داشته باشد، Miner نمیتواند Domain را Resolve کند.
ممکن است اینترنت برقرار باشد اما Pool Connection شکست بخورد.
بررسی موارد زیر میتواند کمک کند:
- DNS Server
- Gateway
- Resolve
- Network Configuration
مرحله هجدهم: Gateway
اگر IP داخلی دستگاه در دسترس باشد اما اینترنت یا Pool کار نکند، Gateway را بررسی کنید.
ممکن است:
- Gateway اشتباه باشد؛
- Route وجود نداشته باشد؛
- NAT مشکل داشته باشد؛
- Firewall ترافیک را مسدود کند.
این سناریو بسیار مهم است:
Local Network = OK
اما:
Pool Connection = Failed
در این شرایط تمرکز عیبیابی باید از ماینر به شبکه بالادستی منتقل شود.
مرحله نوزدهم: Firewall و Port
ارتباط Stratum روی Port مشخصی انجام میشود.
اگر Firewall، Router یا ISP مسیر آن Port را محدود کند، دستگاه ممکن است نتواند به Pool متصل شود.
اگر امکان دارد Endpointهای جایگزین و Portهای پشتیبان تعریف شوند تا در صورت مشکل یک مسیر، دستگاه بتواند Failover کند.
مرحله بیستم: Firmware
گاهی مشکل Offline شدن از Firmware ناشی میشود.
نمونهها:
- Bug
- فایل خراب
- تنظیمات ناسازگار
- Upgrade ناقص
- Watchdog Loop
- Configuration Error
اگر مشکل بلافاصله پس از Firmware Update شروع شده باشد، این ارتباط باید جدی بررسی شود.
قبل از هر Upgrade گروهی در فارم بهتر است نسخه جدید ابتدا روی تعداد محدودی دستگاه آزمایش شود.
Factory Reset آخرین گزینه است، نه اولین گزینه
یکی از اشتباهات رایج در عیبیابی این است که بلافاصله دستگاه Factory Reset شود.
با این کار ممکن است:
- تنظیمات Pool پاک شوند؛
- IP تغییر کند؛
- اطلاعات لازم برای بررسی مشکل از بین برود.
بهتر است ابتدا:
- Logs
- Configuration
- Uptime
- Errorها
ثبت شوند و سپس در صورت نیاز Reset انجام شود.
مرحله بیستویکم: Firmware Update با احتیاط
Firmware Update میتواند بعضی مشکلات را رفع کند اما خود عملیات Update نیز ریسک دارد.
قبل از Update:
- مدل دقیق دستگاه را تأیید کنید؛
- Firmware مناسب همان مدل باشد؛
- تنظیمات مهم ذخیره شوند؛
- برق پایدار باشد؛
- فرآیند Update قطع نشود.
در فارم بزرگ بهتر است Update مرحلهای انجام شود، نه همزمان برای تمام دستگاهها.
دستگاه در Pool Offline است ولی Local Hashrate دارد
این سناریو بسیار مهم است.
مثلاً:
Local Hashrate:
200 TH/s
ولی Pool:
0 TH/s
در این حالت احتمالاً ASIC در حال کار است اما Shareهای دستگاه به مقصد نمیرسند.
بررسی کنید:
- Active Pool
- Network
- DNS
- Gateway
- Reject
- Stratum Connection
- Worker
- Internet
تمرکز روی تعویض Hashboard در این وضعیت احتمالاً مسیر اشتباهی است.
دستگاه Local و Pool هر دو صفر دارد
اگر Web Panel باز میشود ولی:
Local = 0
و:
Pool = 0
مشکل بیشتر به داخل دستگاه مربوط است.
بررسی اولویتدار:
- Kernel Log
- Hashboard
- Temperature
- Fan
- PSU
- Firmware
دستگاه Ping نمیشود ولی Switch آن را میبیند
اگر MAC Address روی Switch دیده میشود اما Ping پاسخ نمیدهد، موارد زیر را بررسی کنید:
- IP
- VLAN
- Subnet Mask
- IP Conflict
- Firewall
- Controller Configuration
وجود MAC نشان میدهد حداقل بخشی از Layer 2 ارتباط دارد.
Switch هم دستگاه را نمیبیند
اگر Link وجود ندارد و MAC نیز مشاهده نمیشود، موارد محتملتر هستند:
- Cable
- Network Port
- Controller
- Power
- Switch Port
در این مرحله تعویض آزمایشی کابل یا پورت میتواند سریعتر مشکل را مشخص کند.
روش حرفهای: یک متغیر را در هر مرحله تغییر دهید
هنگام عیبیابی چند چیز را همزمان تغییر ندهید.
مثلاً همزمان:
- کابل
- Firmware
- Pool
- IP
را تغییر ندهید.
اگر دستگاه درست شود دیگر مشخص نیست علت واقعی چه بوده است.
روش بهتر:
- یک تغییر
- تست
- ثبت نتیجه
- مرحله بعد
این کار برای پیدا کردن مشکلات تکرارشونده بسیار مهم است.
یک چکلیست سریع عیبیابی
وقتی ماینری Offline شد، این ترتیب میتواند مفید باشد:
1. Power
آیا دستگاه روشن است؟
2. Fan / LED
نشانههای Boot دیده میشوند؟
3. Switch Link
پورت شبکه Link دارد؟
4. IP
IP دستگاه مشخص است؟
5. Ping
دستگاه پاسخ میدهد؟
6. Web Panel
صفحه دستگاه باز میشود؟
7. Uptime
آیا اخیراً Restart شده؟
8. Hashrate
Local Hashrate وجود دارد؟
9. Hashboards
تمام بردها شناسایی شدهاند؟
10. Temperature
دمای دستگاه طبیعی است؟
11. Kernel Log
چه خطایی ثبت شده؟
12. Pool
Active Pool چیست؟
13. Internet
ارتباط خارجی برقرار است؟
14. Reject
Shareها پذیرفته میشوند؟
این ترتیب معمولاً محدوده مشکل را بهسرعت کوچک میکند.
تشخیص مشکل با مقایسه گروهی
یکی از بهترین ابزارهای فارم بزرگ، مقایسه دستگاه مشکلدار با دستگاههای اطراف آن است.
فرض کنید Miner 24 Offline شده است.
بررسی کنید:
Miner 23 چه وضعیتی دارد؟
Miner 25 چه وضعیتی دارد؟
اگر همه Offline باشند، مشکل احتمالاً مشترک است.
اگر فقط Miner 24 مشکل دارد، تمرکز روی خود دستگاه منطقیتر است.
همین روش برای:
- Rack
- Switch
- PDU
- Hall
نیز کاربرد دارد.
چرا محل فیزیکی دستگاه باید در سیستم مشخص باشد؟
در فارمی با صدها دستگاه دانستن IP کافی نیست.
بهتر است مشخص باشد:
Site A → Hall 2 → Row 4 → Rack 7 → Miner 18
وقتی Alert دریافت میشود، تکنسین دقیقاً میداند کجا باید مراجعه کند.
این موضوع زمان Mean Time To Repair یا MTTR را کاهش میدهد.
MTTR چیست؟
MTTR یا Mean Time To Repair یعنی متوسط زمانی که از ایجاد مشکل تا بازگشت تجهیز به سرویس طول میکشد.
فرض کنید یک ماینر فقط دو دقیقه طول میکشد تا تعمیر شود، اما:
40 دقیقه طول میکشد تا کسی متوجه خرابی شود.
در واقع بخش اصلی Downtime مربوط به زمان تشخیص بوده است، نه تعمیر.
مانیتورینگ مناسب دقیقاً در این قسمت ارزش خود را نشان میدهد.
هر دقیقه Offline بودن چه اهمیتی دارد؟
در یک دستگاه، چند دقیقه توقف ممکن است ناچیز به نظر برسد.
اما اگر یک فارم:
2,000 Miner
داشته باشد، توقفهای کوچک در مقیاس مجموعه جمع میشوند.
برای همین در مدیریت حرفهای فارم فقط خرابیهای بزرگ مهم نیستند.
Micro-Downtime یا قطعیهای کوتاه و مکرر نیز باید شناسایی شوند.
Alert مناسب برای Offline Miner
یک هشدار خوب نباید با اولین Packet ازدسترفته فعال شود.
برای مثال میتوان منطق زیر را داشت:
Warning
عدم مشاهده دستگاه برای 2 دقیقه.
Critical
Offline بودن برای بیش از 5 دقیقه.
این مقادیر صرفاً مثال هستند و باید متناسب با محیط واقعی تنظیم شوند.
هدف جلوگیری از هشدار کاذب و در عین حال تشخیص سریع مشکل واقعی است.
Alert Storm؛ مشکل پنهان مانیتورینگ
فرض کنید Switch یک سالن قطع شود و 300 ماینر Offline شوند.
اگر سیستم برای هر دستگاه یک Notification مستقل بفرستد، اپراتور ممکن است 300 هشدار دریافت کند.
سیستم حرفهای باید بتواند ارتباط میان رخدادها را در نظر بگیرد.
مثلاً:
300 دستگاه در Hall B همزمان Offline شدند.
این پیام بسیار کاربردیتر از 300 Alert جداگانه است.
تاریخچه Offline/Online را نگه دارید
برای هر دستگاه بهتر است موارد زیر ثبت شوند:
- زمان Offline
- زمان بازگشت
- Duration
- تعداد قطعی
- Restart Count
- علت احتمالی
- اقدام انجامشده
بعد از چند هفته میتوان مشخص کرد کدام ماینرها بیشترین ناپایداری را دارند.
این اطلاعات برای نگهداری پیشگیرانه بسیار ارزشمند است.
مشکل تکرارشونده از خرابی اتفاقی مهمتر است
یک ماینر ممکن است یکبار در ماه Restart شود.
دستگاه دیگری ممکن است روزانه 10 بار Restart شود ولی هر بار خودش برگردد.
ماینر دوم از نظر عملیاتی مشکل مهمتری دارد، حتی اگر هنگام بازدید Online باشد.
به همین دلیل تعداد رخدادها باید در کنار وضعیت فعلی نمایش داده شود.
از خاموش و روشن کردن بیدلیل جلوگیری کنید
Power Cycle یکی از سریعترین روشهای بازگرداندن برخی تجهیزات است، اما نباید جای عیبیابی را بگیرد.
اگر ماینر روزانه Restart میشود و هر بار فقط برق آن قطع و وصل شود، منشأ اصلی مشکل پیدا نمیشود.
قبل از Restart بهتر است در صورت امکان:
- Logs
- Temperature
- Hashboard Status
- Uptime
- Error Code
ثبت شوند.
تفاوت Recovery و Repair
این دو مفهوم یکی نیستند.
Recovery
دستگاه دوباره Online شده است.
Repair
علت اصلی مشکل برطرف شده است.
مثلاً Restart کردن یک ماینر ممکن است آن را Recover کند، اما اگر پاور معیوب باشد احتمالاً چند ساعت بعد دوباره Offline خواهد شد.
هدف نگهداری حرفهای باید پیدا کردن Root Cause باشد.
Root Cause Analysis
اگر خرابی تکرار میشود، فقط آخرین Error را نگاه نکنید.
بررسی کنید:
- چه زمانی رخ میدهد؟
- قبل از آن دما چه بوده؟
- برق چه تغییری داشته؟
- دستگاه روی چه Poolی بوده؟
- آیا دستگاههای اطراف هم مشکل داشتهاند؟
- Firmware مشابه روی دستگاههای دیگر چگونه کار میکند؟
این اطلاعات میتوانند علت اصلی مشکل را آشکار کنند.
مانیتورینگ خوب چه کمکی میکند؟
یک سیستم مانیتورینگ حرفهای باید بتواند حداقل مشخص کند:
- دستگاه Offline است
- از چه زمانی Offline شده
- آخرین Hashrate چه بوده
- آخرین دما چه بوده
- Uptime قبل از قطع چقدر بوده
- چند بار قبلاً Offline شده
- Pool فعال چه بوده
- دستگاه در کدام Rack قرار دارد
هرچه اطلاعات قبل از خرابی بیشتر باشند، عیبیابی سادهتر خواهد بود.
مانیتورینگ جای تکنسین را نمیگیرد
سامانه مانیتورینگ نمیتواند تمام خرابیهای سختافزاری را تعمیر کند.
وظیفه آن این است که:
مشکل را زودتر پیدا کند، محدوده آن را مشخص کند و اطلاعات لازم برای تکنسین فراهم کند.
ترکیب مانیتورینگ دقیق و فرآیند نگهداری منظم باعث کاهش Downtime واقعی فارم میشود.
یک فلو ساده برای عیبیابی
میتوان مسیر تصمیمگیری را به شکل زیر خلاصه کرد:
ماینر Offline است
↓
آیا روشن است؟
خیر → برق / PSU / PDU را بررسی کنید.
بله ↓
آیا در شبکه دیده میشود؟
خیر → Cable / Switch / IP / Controller
بله ↓
Web Panel باز میشود؟
خیر → Network / Controller / Firmware
بله ↓
Local Hashrate دارد؟
خیر → Hashboard / PSU / Temperature / Firmware
بله ↓
Pool Hashrate دارد؟
خیر → Pool / DNS / Gateway / Internet / Reject
بله ↓
دستگاه استخراج میکند و احتمالاً مسئله در سیستم مانیتورینگ یا تعریف Online/Offline است.
جمعبندی
وقتی یک ماینر Offline میشود، نباید بلافاصله فرض کرد دستگاه خراب شده است.
مشکل ممکن است در هرکدام از این بخشها باشد:
برق → PSU → Controller → کابل شبکه → Switch → IP → Firmware → Hashboard → Pool → اینترنت
بهترین روش، عیبیابی مرحلهای و مبتنی بر شواهد است.
در فارمهای بزرگ یک نکته حتی مهمتر وجود دارد:
قبل از بررسی یک دستگاه، ببینید آیا تجهیزات دیگری نیز در همان زمان و همان بخش دچار مشکل شدهاند یا خیر.
این بررسی ساده میتواند بهسرعت مشخص کند با خرابی یک ماینر روبهرو هستیم یا مشکل در زیرساخت مشترک فارم قرار دارد.
هدف نهایی نیز صرفاً Online کردن دستگاه نیست.
هدف باید این باشد که:
علت خرابی شناسایی شود، زمان توقف کاهش پیدا کند و از تکرار همان مشکل جلوگیری شود.
هرچه فارم بزرگتر شود، ثبت تاریخچه رخدادها، مانیتورینگ متمرکز و تشخیص سریع تجهیزات غیرعادی اهمیت بیشتری پیدا میکند.