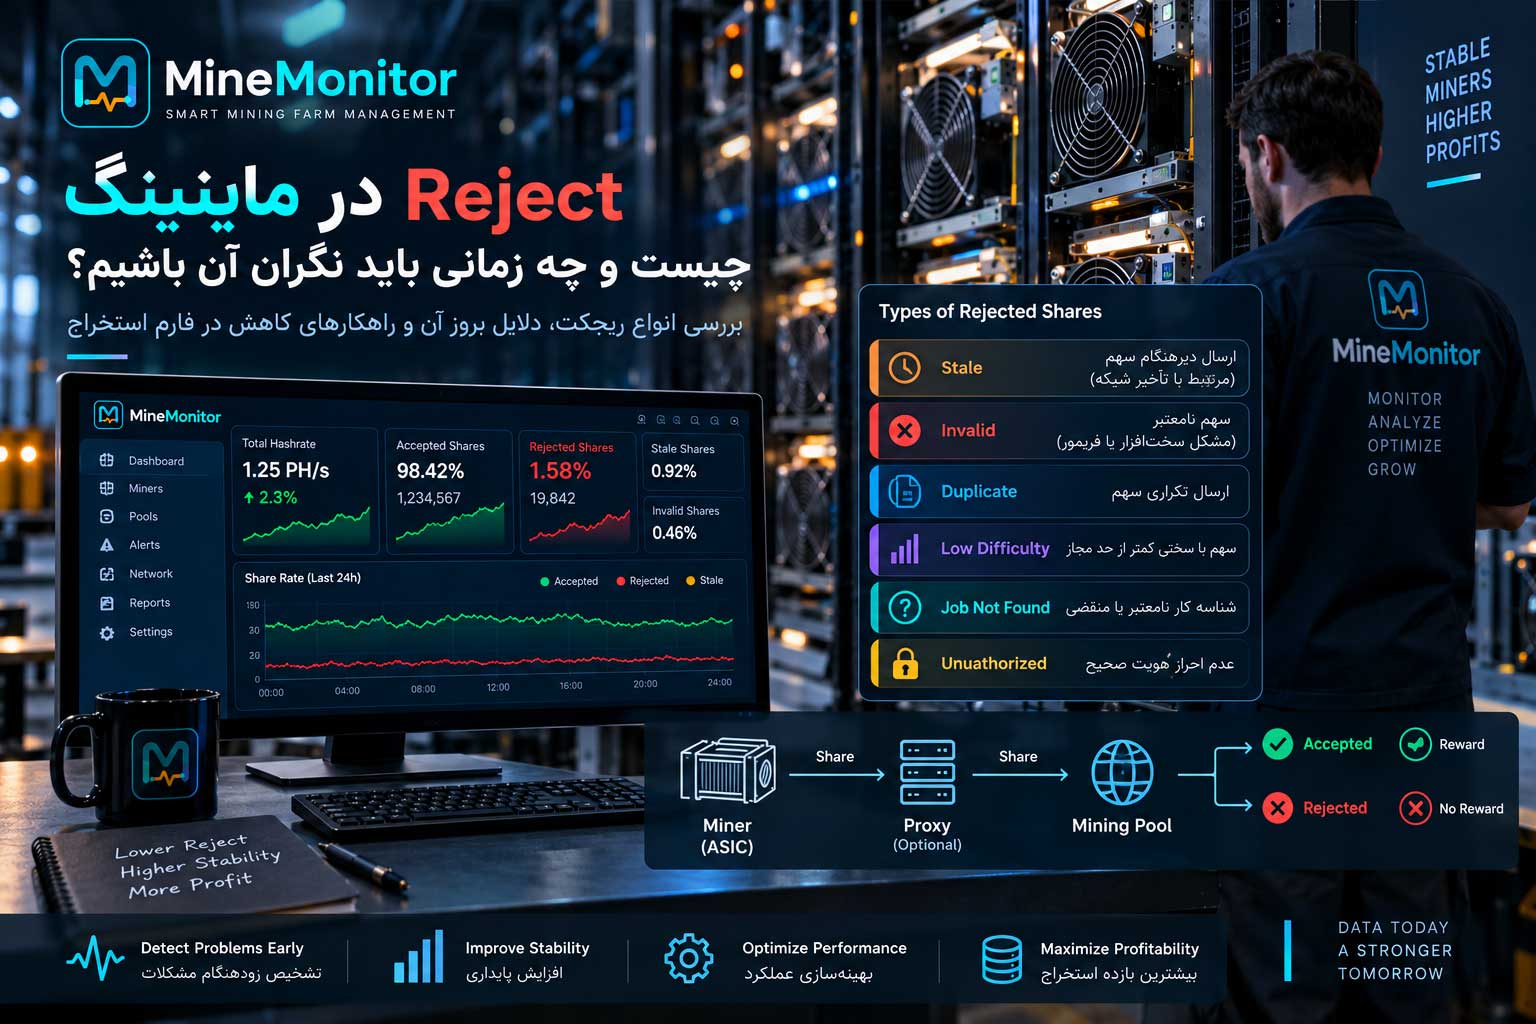
Reject در ماینینگ چیست؟
در استخراج بیتکوین، دستگاههای ماینر با انجام محاسبات رمزنگاری تلاش میکنند یک هش معتبر برای بلاک جدید پیدا کنند.
هنگامی که یک ماینر به استخر استخراج متصل میشود، استخر وظایف محاسباتی مشخصی را در اختیار دستگاه قرار میدهد. ماینر پس از پیدا کردن نتیجهای که شرایط تعیینشده توسط استخر را داشته باشد، آن را در قالب یک Share ارسال میکند.
استخر Share دریافتشده را بررسی میکند و در صورت معتبر بودن، آن را میپذیرد.
اما همه Shareهای ارسالی الزاماً پذیرفته نمیشوند.
اگر یک Share شرایط مورد انتظار استخر را نداشته باشد، تکراری باشد یا پس از منقضی شدن Job مربوطه ارسال شود، ممکن است توسط استخر رد شود.
به این اتفاق Reject یا Rejected Share گفته میشود.
وجود تعداد محدودی Reject در استخراج طبیعی است، اما افزایش مداوم آن میتواند نشاندهنده مشکلی باشد که باید بررسی شود.
ابتدا باید بدانیم Share چیست
برای درک صحیح Reject، ابتدا لازم است مفهوم Share را بشناسیم.
در استخراج استخرمحور، ماینرها برای اثبات میزان کار محاسباتی انجامشده، نتایجی را که از یک سطح سختی مشخص عبور میکنند به استخر ارسال میکنند.
این نتایج Share نام دارند.
سختی Share معمولاً بسیار کمتر از سختی اصلی شبکه بیتکوین است؛ زیرا استخر باید بتواند فعالیت ماینرها را بدون انتظار برای پیدا شدن یک بلاک کامل اندازهگیری کند.
به زبان ساده:
Hash: یک عملیات محاسباتی توسط دستگاه
Share: نتیجهای که شرایط سختی تعیینشده توسط استخر را دارد
Accepted Share: سهم معتبر پذیرفتهشده توسط استخر
Rejected Share: سهم ردشده توسط استخر
Block: نتیجهای که علاوه بر شرایط Share، شرایط سختی شبکه بیتکوین را نیز برآورده میکند
نکته مهم این است که تعداد Shareها لزوماً معادل تعداد هشهای انجامشده نیست.
هر Share میتواند دارای Difficulty متفاوتی باشد و هنگام ارزیابی عملکرد باید این موضوع در نظر گرفته شود.
تفاوت Accepted و Rejected Share
وقتی ماینر یک Share ارسال میکند، استخر معمولاً نتیجه پردازش آن را به دستگاه اعلام میکند.
Accepted Share
وقتی Share معتبر است و مطابق شرایط استخر پذیرفته میشود، در بخش Accepted ثبت خواهد شد.
در روشهای پرداخت مبتنی بر سهم، این کار پذیرفتهشده در محاسبات استخر نقش دارد.
Rejected Share
وقتی Share به دلایلی مانند قدیمی بودن Job، تکراری بودن یا نامعتبر بودن رد شود، ممکن است در آمار Rejected ثبت شود.
این Share معمولاً در اعتبار کار پذیرفتهشده برای پرداخت محاسبه نمیشود.
بنابراین در یک فارم حرفهای، فقط بالا بودن هشریت کافی نیست؛ کیفیت Shareهایی که به استخر تحویل داده میشوند نیز اهمیت دارد.
انواع Reject در استخراج بیتکوین
یکی از مهمترین نکات عیبیابی این است که تمام Rejectها دلیل یکسانی ندارند.
اگر تنها درصد ریجکت را بررسی کنیم، ممکن است منشأ اصلی مشکل مشخص نشود.
مهمترین انواع خطا عبارتاند از:
| نوع خطا | مفهوم | منشأ احتمالی |
|---|---|---|
| Stale Share | سهم مربوط به Job قدیمی است | تأخیر یا تعویض Job |
| Invalid Share | سهم از نظر اعتبار محاسباتی مشکل دارد | سختافزار، Firmware یا نرمافزار |
| Duplicate Share | یک نتیجه تکراری ارسال شده است | Firmware یا Proxy |
| Low Difficulty | سهم حداقل سختی لازم را ندارد | تنظیم Difficulty یا خطای محاسباتی |
| Job Not Found | شناسه Job معتبر شناخته نمیشود | Job منقضیشده یا ناهماهنگی اتصال |
| Unauthorized | دستگاه یا حساب مجاز شناخته نمیشود | تنظیمات احراز هویت |
نام دقیق خطاها و نحوه دستهبندی آنها ممکن است بین استخرها و نسخههای Stratum متفاوت باشد.
همچنین برخی از خطاهای مربوط به احراز هویت الزاماً در آمار Rejected Share قرار نمیگیرند.
۱. Stale Share؛ یکی از رایجترین دلایل ریجکت
Stale زمانی اتفاق میافتد که ماینر نتیجهای را برای کاری ارسال کند که دیگر از نظر استخر معتبر نیست.
برای مثال، فرض کنید ماینر در حال محاسبه روی یک Job است.
در همین زمان بلاک جدیدی در شبکه بیتکوین پیدا میشود و استخر Job جدیدی را جایگزین کار قبلی میکند.
اگر دستگاه همچنان نتیجه مربوط به Job قدیمی را ارسال کند، آن Share ممکن است Stale تشخیص داده شود.
چرا Stale ایجاد میشود؟
دلایل رایج عبارتاند از:
تأخیر در دریافت Job جدید
تأخیر در ارسال Share
ناپایداری ارتباط اینترنت
Packet Loss
تأخیر پردازش در Proxy
کندی واکنش Firmware به تغییر Job
تغییر مسیر اتصال به استخر
البته مقدار کمی Stale حتی در ارتباطات سالم نیز ممکن است اتفاق بیفتد.
چگونه Stale را کاهش دهیم؟
اولین اقدام بررسی کیفیت مسیر ارتباط دستگاه تا استخر است.
بهتر است علاوه بر میانگین تأخیر، نوسان تأخیر و Packet Loss نیز بررسی شود.
انتخاب سرور مناسب استخر، استفاده از شبکه داخلی پایدار و جلوگیری از تغییرات مکرر اتصال میتواند در کاهش Stale مؤثر باشد.
۲. Invalid Share؛ زمانی که نتیجه محاسبات معتبر نیست
Invalid Share به سهمی گفته میشود که از نظر بررسیهای اعتبارسنجی استخر قابل قبول نباشد.
این مسئله ممکن است به دلایل مختلفی ایجاد شود.
برای مثال:
خطای محاسباتی ASIC
تنظیمات ناپایدار Overclock
مشکل Firmware
اشکال در تولید یا پردازش Job
ناسازگاری نرمافزار واسط
اختلال در دادههای مورد استفاده برای محاسبات
نکته مهم این است که Invalid Share همیشه به معنی خرابی فیزیکی هشبرد نیست.
گاهی یک مشکل نرمافزاری یا تنظیم نادرست نیز میتواند باعث ایجاد این خطا شود.
Hardware Error و Invalid Share چه تفاوتی دارند؟
Hardware Error معمولاً خطایی است که خود دستگاه یا Firmware در فرآیند محاسبات شناسایی میکند.
اما Rejected Share نتیجهای است که به استخر ارسال شده و در سمت دریافتکننده رد شده است.
بنابراین هر Hardware Error الزاماً به یک Rejected Share تبدیل نمیشود.
این دو شاخص باید جداگانه بررسی شوند.
۳. Duplicate Share؛ ارسال تکراری یک نتیجه
Duplicate Share زمانی رخ میدهد که استخر نتیجهای را دریافت کند که قبلاً برای همان زمینه معتبر محاسباتی ثبت شده است.
این مشکل میتواند در شرایط زیر رخ دهد:
ارسال تکراری یک Share
خطای مدیریت Job در Firmware
مشکل در Proxy
مدیریت نادرست Extranonce
تولید کار تکراری در زیرساخت واسط
اشکال در فرآیند بازیابی اتصال
در فارمهایی که از Mining Proxy استفاده میکنند، این نوع خطا اهمیت ویژهای دارد.
Proxy باید بتواند Jobها، اطلاعات اتصال و فضای محاسباتی ماینرهای متصل را بهدرستی مدیریت کند.
در غیر این صورت احتمال تولید یا ارسال Share تکراری افزایش پیدا میکند.
۴. Low Difficulty Share
استخر برای ماینر یک سطح Difficulty تعیین میکند.
ماینر باید Shareهایی ارسال کند که حداقل سختی مورد انتظار را داشته باشند.
اگر یک Share از نظر هش محاسبهشده به سطح مورد نظر نرسیده باشد، ممکن است با خطای Low Difficulty رد شود.
دلایل احتمالی:
ناهماهنگی Difficulty میان ماینر و استخر
اشکال در مدیریت تغییر Difficulty
خطای Firmware
مشکل در Proxy
تولید یک نتیجه نامعتبر توسط سختافزار
این خطا را نباید صرفاً به بالا بودن یا پایین بودن هشریت دستگاه نسبت داد.
برای تشخیص دقیق باید زمان تغییر Difficulty، Job مرتبط و وضعیت نرمافزار دستگاه بررسی شود.
۵. Job Not Found
در این وضعیت، استخر شناسه Job ارسالی توسط ماینر را معتبر یا موجود تشخیص نمیدهد.
ممکن است Job قبلاً منقضی شده باشد یا دستگاه در حال استفاده از اطلاعات مربوط به یک اتصال قدیمی باشد.
این خطا بهخصوص هنگام تغییر Job، قطع و وصل شدن اتصال یا بروز مشکل در مدیریت وضعیت Proxy اهمیت دارد.
اگر خطای Job Not Found بهصورت مداوم رخ دهد، باید ارتباط زمانی میان رویدادهای زیر بررسی شود:
ایجاد Job جدید
قطع ارتباط
اتصال مجدد
تغییر سرور
ارسال Share
تغییر Difficulty
درصد Reject چگونه محاسبه میشود؟
در سادهترین حالت، اگر تمام Shareها دارای Difficulty یکسان باشند، میتوان درصد Reject را به شکل زیر محاسبه کرد:
[
\text{Reject Rate}=\frac{\text{Rejected}}{\text{Accepted}+\text{Rejected}}\times100
]
برای مثال:
Accepted Shares: 9,900
Rejected Shares: 100
در این حالت درصد Reject برابر است با:
1%
اما این فرمول یک محدودیت مهم دارد.
چرا شمارش ساده Shareها همیشه دقیق نیست؟
استخرهای استخراج میتوانند برای دستگاههای مختلف یا حتی برای یک دستگاه در زمانهای متفاوت، Share Difficulty متفاوتی تعیین کنند.
بنابراین ارزش محاسباتی تمام Shareها الزاماً یکسان نیست.
فرض کنید:
100 Share پذیرفتهشده با Difficulty برابر 8192 داریم.
10 Share ردشده با Difficulty برابر 1024 داریم.
اگر فقط تعداد را حساب کنیم، درصد Reject حدود 9.09 درصد خواهد شد.
اما از نظر حجم کار معادل، شرایط متفاوت است.
برای محاسبه دقیقتر، باید مجموع Difficulty سهمهای پذیرفتهشده و ردشده را در نظر گرفت.
[
\text{Reject Rate}=\frac{\sum D_{\text{Rejected}}}{\sum D_{\text{Accepted}}+\sum D_{\text{Rejected}}}\times100
]
در مثال بالا، مقدار محاسبهشده بر اساس Difficulty حدود 1.23 درصد خواهد بود.
این اختلاف بسیار مهم است.
به همین دلیل در تحلیل حرفهای استخرها، استفاده از Difficulty-Weighted Reject Rate در صورت دسترسی به اطلاعات مناسب، معیار دقیقتری از شمارش ساده Shareها محسوب میشود.
نکته: بعضی استخرها Stale را بهعنوان زیرمجموعه Rejected و بعضی بهصورت جداگانه گزارش میکنند. پیش از محاسبه باید تعریف آمار مشخص شود تا هیچ سهمی دوبار شمرده نشود.
چه درصدی از Reject طبیعی است؟
یکی از پرتکرارترین پرسشها این است:
آیا 1 درصد Reject زیاد است؟
پاسخ به شرایط دستگاه، کیفیت ارتباط و روش محاسبه بستگی دارد.
هیچ عدد واحدی برای تمام فارمها و تمام استخرها وجود ندارد.
اما برای ارزیابی اولیه میتوان از محدودههای راهنمای زیر استفاده کرد.
| درصد Reject | ارزیابی اولیه |
|---|---|
| کمتر از 0.5% | معمولاً مطلوب |
| 0.5 تا 1% | قابل بررسی، بهویژه اگر رو به افزایش باشد |
| 1 تا 2% | بهتر است علت شناسایی شود |
| 2 تا 5% | نامطلوب و نیازمند عیبیابی |
| بیشتر از 5% | مشکل جدی و نیازمند بررسی سریع |
این مقادیر حدود عملیاتی پیشنهادی هستند، نه استاندارد قطعی برای همه تجهیزات.
همچنین نباید بر اساس تنها چند Share درباره وضعیت دستگاه قضاوت کرد.
چرا بازه زمانی مهم است؟
فرض کنیم یک ماینر تازه به استخر متصل شده و فقط 10 Share ارسال کرده است.
اگر یکی از آنها Reject شود، نرخ شمارشی برابر 10 درصد خواهد بود.
اما این مقدار برای نتیجهگیری درباره عملکرد بلندمدت کافی نیست.
در مقابل، اگر پس از دریافت حجم زیادی Share در چند ساعت، نرخ Reject همچنان بالا باقی بماند، بررسی مشکل منطقیتر خواهد بود.
چرا Reject بالا برای فارم اهمیت دارد؟
در استخراج استخرمحور، معیار اصلی دریافت اعتبار، کار معتبری است که استخر طبق قواعد خود میپذیرد.
اگر بخشی از کار انجامشده توسط ماینر رد شود، ممکن است آن مقدار در محاسبه کار قابل پرداخت لحاظ نشود.
در نتیجه، دستگاه همچنان برق مصرف کرده و عملیات محاسباتی انجام داده است، اما بخشی از نتایج آن پذیرفته نشدهاند.
یک مثال کاربردی
فرض کنیم یک فارم با هشریت واقعی 10 PH/s فعالیت میکند.
اگر در یک بازه طولانی، نرخ رد شدن کار محاسباتی آن 2 درصد باشد، بهصورت تقریبی میتوان گفت معادل 0.2 PH/s از کار ارسالی آن در بخش Accepted اعتبار نگرفته است.
البته این عدد به معنای کاهش دقیق و قطعی 2 درصدی درآمد در هر مدل پرداخت نیست؛ زیرا روش محاسبه پاداش، تغییرات Difficulty و شرایط استخراج نیز اهمیت دارند.
اما نشان میدهد چرا حتی چند درصد Reject در مقیاس یک فارم بزرگ باید بررسی شود.
ارتباط Reject با هشریت واقعی
یکی از نکات مهم این است که هشریت داخل ماینر و هشریت ثبتشده در استخر یکسان محاسبه نمیشوند.
Local Hashrate نشاندهنده عملکرد گزارششده توسط خود دستگاه است.
اما Pool-side Hashrate از Shareهای دریافتشده توسط استخر تخمین زده میشود.
فرض کنیم دستگاه:
Local Hashrate: 200 TH/s
را نشان میدهد.
اما در استخر میانگین کمتری مشاهده میشود.
اگر اختلاف در یک بازه طولانی ادامه داشته باشد، باید موارد زیر بررسی شوند:
Reject
Stale
اتصال ناپایدار
تغییر Pool
مدتزمان استخراج واقعی
بازه زمانی میانگینگیری
Difficulty سهمهای ثبتشده
اختلاف هشریت Local و Pool الزاماً ناشی از Reject نیست.
نوسان آماری Shareها یا خارج شدن دستگاه از مدار نیز میتواند همین اختلاف را ایجاد کند.
آیا قطعی اینترنت همیشه باعث Reject میشود؟
خیر.
این یکی از نکات مهم در تحلیل مشکلات فارم است.
قطع ارتباط میتواند باعث شود ماینر برای مدتی هیچ Share جدیدی به استخر ارسال نکند.
در چنین حالتی احتمال دارد هشریت سمت استخر کاهش پیدا کند، بدون آنکه تعداد زیادی Reject ثبت شود.
در مقابل، هنگام تغییر Job و تأخیر در ارسال نتایج ممکن است Stale افزایش یابد.
بنابراین:
Reject پایین الزاماً به معنای اتصال کاملاً پایدار نیست.
بهترین روش بررسی همزمان چند شاخص است:
Accepted Work
Rejected Work
Stale Shares
Disconnect Count
Connection Uptime
Pool-side Hashrate
تأثیر Latency و Packet Loss
کیفیت ارتباط شبکه یکی از عوامل مؤثر بر عملکرد استخراج است.
Latency
Latency مدت زمانی است که انتقال داده در مسیر ارتباطی طول میکشد.
افزایش تأخیر میتواند زمان رسیدن Job جدید یا Share ارسالی را افزایش دهد.
این موضوع بهویژه در زمان تغییر بلاک یا منقضیشدن Job اهمیت دارد.
Packet Loss
Packet Loss به معنای از دست رفتن بستههای شبکه است.
در ارتباطات TCP که معمولاً برای Stratum V1 استفاده میشود، از دست رفتن بسته میتواند باعث ارسال مجدد، تأخیر یا در شرایط شدید قطع ارتباط شود.
Jitter
Jitter نوسان در میزان تأخیر شبکه است.
ممکن است میانگین تأخیر یک مسیر مناسب باشد، اما گاهی تأخیرهای غیرعادی ایجاد شوند.
برای همین در بررسی ارتباط استخراج، تنها مشاهده عدد Ping کافی نیست.
بهتر است کیفیت ارتباط در طول زمان بررسی شود.
چرا بعضی ماینرها Reject بیشتری دارند؟
اگر تمام تجهیزات یک فارم به یک استخر متصل هستند، ممکن است تنها چند دستگاه درصد Reject بالاتری داشته باشند.
در این وضعیت بهتر است منشأ مشکل را در همان تجهیزات جستوجو کنیم.
موارد محتمل عبارتاند از:
Firmware متفاوت
ناپایداری پردازش
Overclock غیرپایدار
مشکل شبکه همان دستگاه
خرابی کابل
Restart مکرر
خطای هشبرد
تأخیر غیرعادی در ارسال Share
اما اگر تعداد زیادی دستگاه بهطور همزمان دچار افزایش Reject شوند، بررسی زیرساخت مشترک اولویت بیشتری دارد.
تشخیص مشکل با مقایسه گروهی
در فارمهای بزرگ، الگوی توزیع Reject گاهی اطلاعات بیشتری از خود درصد آن ارائه میکند.
| الگوی مشاهدهشده | اولویت بررسی |
|---|---|
| یک ماینر Reject بالا دارد | دستگاه، Firmware و اتصال محلی |
| تمام دستگاههای یک رک مشکل دارند | Switch یا شبکه همان رک |
| تمام فارم همزمان Stale بالا دارد | اینترنت، Proxy یا مسیر استخر |
| فقط یک مدل ماینر مشکل دارد | Firmware و تنظیمات مشترک |
| Reject بعد از تغییر Pool افزایش یافته | مسیر و تنظیمات استخر جدید |
| Reject بعد از فعالشدن Proxy افزایش یافته | مدیریت Job، Difficulty و Extranonce |
| Reject همراه با Hardware Error افزایش یافته | پایداری سختافزار و تنظیمات توان |
این جدول نشان میدهد چرا مکان فیزیکی تجهیزات و تاریخچه رخدادها در مانیتورینگ اهمیت دارند.
آیا Mining Proxy باعث افزایش Reject میشود؟
وجود Proxy بهخودیخود به معنای افزایش Reject نیست.
یک Proxy مناسب میتواند اتصال تعداد زیادی ماینر به استخر را مدیریت کند و بعضی فرآیندهای ارتباطی را متمرکز سازد.
اما معماری یا تنظیمات نادرست Proxy ممکن است مشکلاتی ایجاد کند.
برای مثال:
تأخیر در انتقال Job جدید
ارسال Share مربوط به Job منقضیشده
اشکال در مدیریت Difficulty
ارسال تکراری Share
مدیریت نادرست Extranonce
قطع و وصل شدن بیش از حد ارتباط Upstream
ناهماهنگی وضعیت اتصال پس از Reconnect
بنابراین هنگام استفاده از Proxy باید بتوان وضعیت دو بخش را مستقل بررسی کرد:
Downstream: ارتباط ماینرها با Proxy
Upstream: ارتباط Proxy با استخر
این تفکیک مشخص میکند Share در کدام مرحله رد شده است.
آیا نگه داشتن Shareها هنگام قطع استخر راهکار خوبی است؟
نه همیشه.
اگر ارتباط Proxy با استخر قطع شود، نگهداری نامحدود Shareها و ارسال آنها پس از اتصال مجدد میتواند باعث افزایش Stale یا خطاهای Job Not Found شود.
زیرا ممکن است Job قبلی دیگر معتبر نباشد.
در طراحی یک Proxy حرفهای، مدیریت عمر Job، اعتبار Share و وضعیت اتصال بسیار مهمتر از ایجاد یک صف بزرگ برای نگهداری نتایج قدیمی است.
هدف اصلی باید بازیابی سریع ارتباط و دریافت کار معتبر جدید باشد.
چرا تغییر مکرر Pool همیشه راهکار خوبی نیست؟
گاهی هنگام مشاهده Reject بالا، اولین اقدام اپراتور تغییر استخر است.
اما این کار همیشه مشکل را برطرف نمیکند.
اگر منشأ Reject، خرابی سختافزار، ناپایداری Firmware یا مشکل شبکه داخلی باشد، تغییر Pool ممکن است هیچ تأثیری نداشته باشد.
از طرف دیگر تغییر مداوم Pool میتواند باعث افزایش دفعات اتصال مجدد و ناپایداری عملیات استخراج شود.
بهتر است قبل از تغییر استخر موارد زیر بررسی شوند:
آیا مشکل فقط روی یک سرور اتفاق میافتد؟
آیا تمام دستگاهها مشکل دارند؟
آیا Stale افزایش یافته یا Invalid؟
آیا تغییر سرور واقعاً Latency را کاهش میدهد؟
آیا مشکل همزمان با تغییر تنظیمات آغاز شده است؟
تعویض Pool باید براساس داده انجام شود، نه صرفاً مشاهده یک عدد لحظهای.
بهترین روش عیبیابی Reject بالا
برای پیدا کردن منشأ مشکل، بهتر است فرآیند عیبیابی مرحلهای انجام شود.
مرحله اول: بازه زمانی را مشخص کنید
درصد Reject را در بازههای زیر بررسی کنید:
5 دقیقه
1 ساعت
24 ساعت
اگر فقط یک افزایش کوتاهمدت رخ داده است، ابتدا بررسی کنید آیا همزمان Job جدید، تغییر Pool یا اتصال مجدد اتفاق افتاده است.
مرحله دوم: نوع Reject را پیدا کنید
مشخص کنید خطای اصلی چیست:
Stale
Invalid
Duplicate
Low Difficulty
Job Not Found
نوع خطا میتواند محدوده عیبیابی را بسیار کوچکتر کند.
مرحله سوم: دستگاههای دیگر را مقایسه کنید
آیا مشکل فقط در یک ماینر وجود دارد یا در چندین دستگاه؟
این سؤال مشخص میکند بررسی باید از دستگاه آغاز شود یا زیرساخت مشترک.
مرحله چهارم: شبکه را بررسی کنید
کیفیت ارتباط داخلی و مسیر استخر را کنترل کنید.
موارد مهم:
Packet Loss
نوسان Latency
Disconnect
خطاهای Switch
پایداری مسیر ارتباطی
مرحله پنجم: Firmware و سختافزار را بررسی کنید
اگر مشکل محدود به یک دستگاه است، موارد زیر را بررسی کنید:
Hardware Error
دمای دستگاه
وضعیت هشبرد
Power Mode
تنظیمات Overclock
Kernel Log
Uptime
مرحله ششم: Proxy و Pool را بررسی کنید
اگر تعداد زیادی دستگاه همزمان مشکل دارند، بررسی موارد زیر مفید است:
ارتباط Upstream
زمان تغییر Job
وضعیت Reconnect
خطاهای Share Submit
مدیریت Difficulty
تغییرات تنظیمات ارتباطی
مرحله هفتم: تنها یک متغیر را تغییر دهید
برای مثال ابتدا سرور استخر را تغییر دهید و نتیجه را بررسی کنید.
اگر مشکل باقی بود، سراغ متغیر بعدی بروید.
تغییر همزمان Firmware، شبکه و Pool باعث میشود تشخیص علت واقعی مشکل دشوار شود.
چگونه برای Reject هشدار مناسب تعریف کنیم؟
در مانیتورینگ حرفهای، هدف تنها نمایش درصد Reject نیست.
سیستم باید بتواند افزایش غیرعادی این شاخص را تشخیص دهد.
اما هشدارهای بیش از حد نیز مشکلساز هستند.
برای مثال اگر با هر Share ردشده یک Alert صادر شود، اپراتور ممکن است روزانه صدها پیام غیرضروری دریافت کند.
روش مناسبتر استفاده از میانگین زمانی و Threshold قابل تنظیم است.
نمونه تنظیم پیشنهادی
Warning
Reject بالاتر از 1 درصد برای مدت 30 دقیقه، با حجم نمونه کافی.
Critical
Reject بالاتر از 3 درصد برای مدت 15 دقیقه، با حجم نمونه کافی.
Recovery
بازگشت نرخ Reject به کمتر از محدوده هشدار و باقی ماندن آن در وضعیت طبیعی برای مدت مشخص.
این اعداد تنها نمونهای برای طراحی منطق هشدار هستند.
در محیط واقعی بهتر است Threshold بر اساس رفتار عادی فارم، نوع ماینر و شرایط شبکه تنظیم شود.
Hysteresis چیست؟
Hysteresis به این معناست که شرط فعال شدن هشدار و شرط پایان آن دقیقاً یکسان نباشند.
برای مثال:
هشدار زمانی فعال شود که Reject از 1 درصد بالاتر رود.
اما زمانی پایان یابد که نرخ آن به کمتر از 0.7 درصد برسد.
این روش کمک میکند هشدار در نزدیکی یک Threshold مرتباً فعال و غیرفعال نشود.
اهمیت تاریخچه Reject
اگر تنها درصد فعلی Reject نمایش داده شود، بسیاری از مشکلات قابل شناسایی نخواهند بود.
برای مثال فرض کنید نرخ Reject فعلی 0.8 درصد است.
این عدد بهتنهایی ممکن است نگرانکننده نباشد.
اما اگر دستگاه طی چند هفته گذشته همواره 0.1 درصد Reject داشته و ناگهان به 0.8 درصد رسیده باشد، تغییر ایجادشده ارزش بررسی دارد.
به همین دلیل نمودار تاریخی یکی از ابزارهای مهم تحلیل است.
بهتر است بتوان تغییرات Reject را با شاخصهای زیر مقایسه کرد:
Hashrate
Temperature
Pool Connection
Network Latency
Restart Events
Firmware Changes
ارتباط زمانی میان این رخدادها میتواند منشأ مشکل را مشخص کند.
Reject پایین همیشه به معنی عملکرد عالی نیست
این نکته بسیار مهم است.
فرض کنید دو ماینر داریم.
ماینر اول
Local Hashrate: 200 TH/s
Reject: 0.2%
Uptime: 99.9%
ماینر دوم
Local Hashrate: 200 TH/s
Reject: 0.1%
Uptime: 85%
ماینر دوم Reject کمتری دارد، اما مدتزمان بیشتری خارج از مدار بوده است.
بنابراین ممکن است در مجموع کار پذیرفتهشده بسیار کمتری تحویل استخر داده باشد.
به همین دلیل برای ارزیابی صحیح عملکرد باید شاخصهای زیر در کنار هم دیده شوند:
Hashrate + Accepted Work + Reject + Uptime + Downtime
هیچکدام از این اعداد بهتنهایی تصویر کاملی ارائه نمیکنند.
نقش مانیتورینگ متمرکز در کاهش Reject
در فارمهایی با تعداد زیاد دستگاه، بررسی دستی Reject هر ماینر بسیار زمانبر است.
یک سامانه مانیتورینگ مناسب میتواند امکان بررسی سریعتر وضعیت تجهیزات را فراهم کند.
برای مثال مدیر فارم باید بتواند متوجه شود:
چند دستگاه Reject غیرعادی دارند؟
کدام دستگاهها بیشترین افزایش را تجربه کردهاند؟
مشکل از چه زمانی آغاز شده است؟
آیا تجهیزات مشکلدار در یک بخش مشترک قرار دارند؟
آیا همزمان هشریت کاهش پیدا کرده است؟
آیا Restart یا Disconnect نیز رخ داده است؟
البته دسترسی به برخی از این اطلاعات به قابلیتهای دستگاه، Firmware، استخر و منابع داده سامانه مانیتورینگ بستگی دارد.
هدف اصلی این است که اپراتور مجبور نباشد هزاران دستگاه را بهصورت دستی بررسی کند.
چکلیست عملی کاهش Reject در فارم
برای بررسی دورهای کیفیت استخراج میتوان از چکلیست زیر استفاده کرد:
| مورد بررسی | هدف |
|---|---|
| نرخ Reject یکساعته | شناسایی مشکلات پایدار اخیر |
| نرخ Reject بیستوچهارساعته | ارزیابی عملکرد بلندمدت |
| نسبت Stale | بررسی تأخیر و وضعیت Job |
| Invalid Share | شناسایی مشکلات اعتبار محاسبات |
| Duplicate Share | بررسی Firmware و Proxy |
| وضعیت Active Pool | کنترل مقصد واقعی استخراج |
| تعداد Disconnectها | بررسی ناپایداری ارتباط |
| Hardware Error | ارزیابی سلامت محاسبات دستگاه |
| Kernel Log | شناسایی خطاهای فنی |
| Local و Pool Hashrate | تشخیص اختلاف عملکرد |
| وضعیت شبکه | بررسی Latency و Packet Loss |
| تاریخچه تغییرات | پیدا کردن زمان شروع مشکل |
بهتر است پس از هر تغییر مهم در Firmware، شبکه، Proxy یا تنظیمات استخر، وضعیت Reject دوباره بررسی و با دوره قبل مقایسه شود.
چند اشتباه رایج در مدیریت Reject
اشتباه اول: تصمیمگیری براساس چند دقیقه اطلاعات
نوسان کوتاهمدت همیشه به معنای مشکل پایدار نیست.
اشتباه دوم: محاسبه صرفاً بر اساس تعداد Share
وقتی Difficulty متفاوت است، مقایسه تعداد خام میتواند گمراهکننده باشد.
اشتباه سوم: نسبت دادن تمام Rejectها به اینترنت
بعضی Rejectها منشأ سختافزاری، نرمافزاری یا مربوط به مدیریت Job دارند.
اشتباه چهارم: تغییر مداوم سرور استخر
تعویض بیدلیل سرور ممکن است تشخیص علت را دشوارتر کند.
اشتباه پنجم: نادیده گرفتن تاریخچه
ممکن است مشکل در زمان مشاهده برطرف شده باشد، اما چند ساعت قبل باعث افت قابل توجه عملکرد شده باشد.
اشتباه ششم: توجه نکردن به حجم کار پذیرفتهشده
ممکن است Reject پایین باشد، اما دستگاه به دلیل قطعیهای مکرر Share بسیار کمی ارسال کرده باشد.
آینده مدیریت Reject در فارمهای بزرگ
با افزایش تعداد ماینرها و استفاده گستردهتر از Proxy، اتوماسیون و سیستمهای مانیتورینگ، تحلیل Reject نیز اهمیت بیشتری پیدا میکند.
در آینده، تمرکز صرفاً بر نمایش یک درصد نخواهد بود.
سیستمهای پیشرفته میتوانند با تحلیل همزمان شاخصهای مختلف، الگوهای غیرعادی را سریعتر شناسایی کنند.
برای مثال:
افزایش Stale همزمان با افزایش Latency
میتواند نشانه مشکل ارتباطی باشد.
افزایش Invalid همزمان با افزایش Hardware Error
میتواند بررسی سختافزار یا تنظیمات دستگاه را در اولویت قرار دهد.
افزایش Reject در تمام دستگاههای یک Proxy
میتواند نشاندهنده مشکلی در لایه ارتباطی یا مدیریت Job باشد.
این نوع تحلیل، مانیتورینگ را از نمایش ساده دادهها به یک ابزار تصمیمگیری عملیاتی تبدیل میکند.
جمعبندی
Reject یکی از مهمترین شاخصهای کیفیت کار ارسالشده توسط ماینر به استخر استخراج است.
وجود تعداد محدودی Share ردشده لزوماً نشاندهنده خرابی نیست، اما افزایش مداوم آن باید بررسی شود.
مهمترین نکته این است که تمام Rejectها دلیل یکسانی ندارند.
Stale معمولاً به اعتبار زمانی Job و تأخیر ارتباط مربوط میشود.
Invalid میتواند ناشی از مشکلات محاسباتی یا نرمافزاری باشد.
Duplicate ممکن است به مدیریت نادرست Share و Job مربوط شود.
Low Difficulty نیز میتواند نشانه ناهماهنگی Difficulty یا خطای اعتبار محاسبات باشد.
برای ارزیابی حرفهای بهتر است نرخ Reject در بازههای زمانی مختلف بررسی شود و در صورت تغییر Difficulty، محاسبات بر اساس حجم کار معادل انجام گیرد.
همچنین Reject باید در کنار هشریت واقعی، Accepted Work، کیفیت اتصال، Uptime و تاریخچه خطاها تحلیل شود.
هدف نهایی رسیدن به یک عدد ظاهراً نزدیک به صفر نیست؛ هدف این است که بیشترین مقدار ممکن از توان پردازشی واقعی فارم به کار معتبر پذیرفتهشده توسط استخر تبدیل شود.
در فارمهای بزرگ، شناسایی سریع افزایش Reject و پیدا کردن منشأ آن میتواند به حفظ ظرفیت عملیاتی و کاهش اتلاف کار محاسباتی کمک کند.